Los riesgos extremos de la inteligencia artificial ya se debaten dentro de las grandes tecnológicas
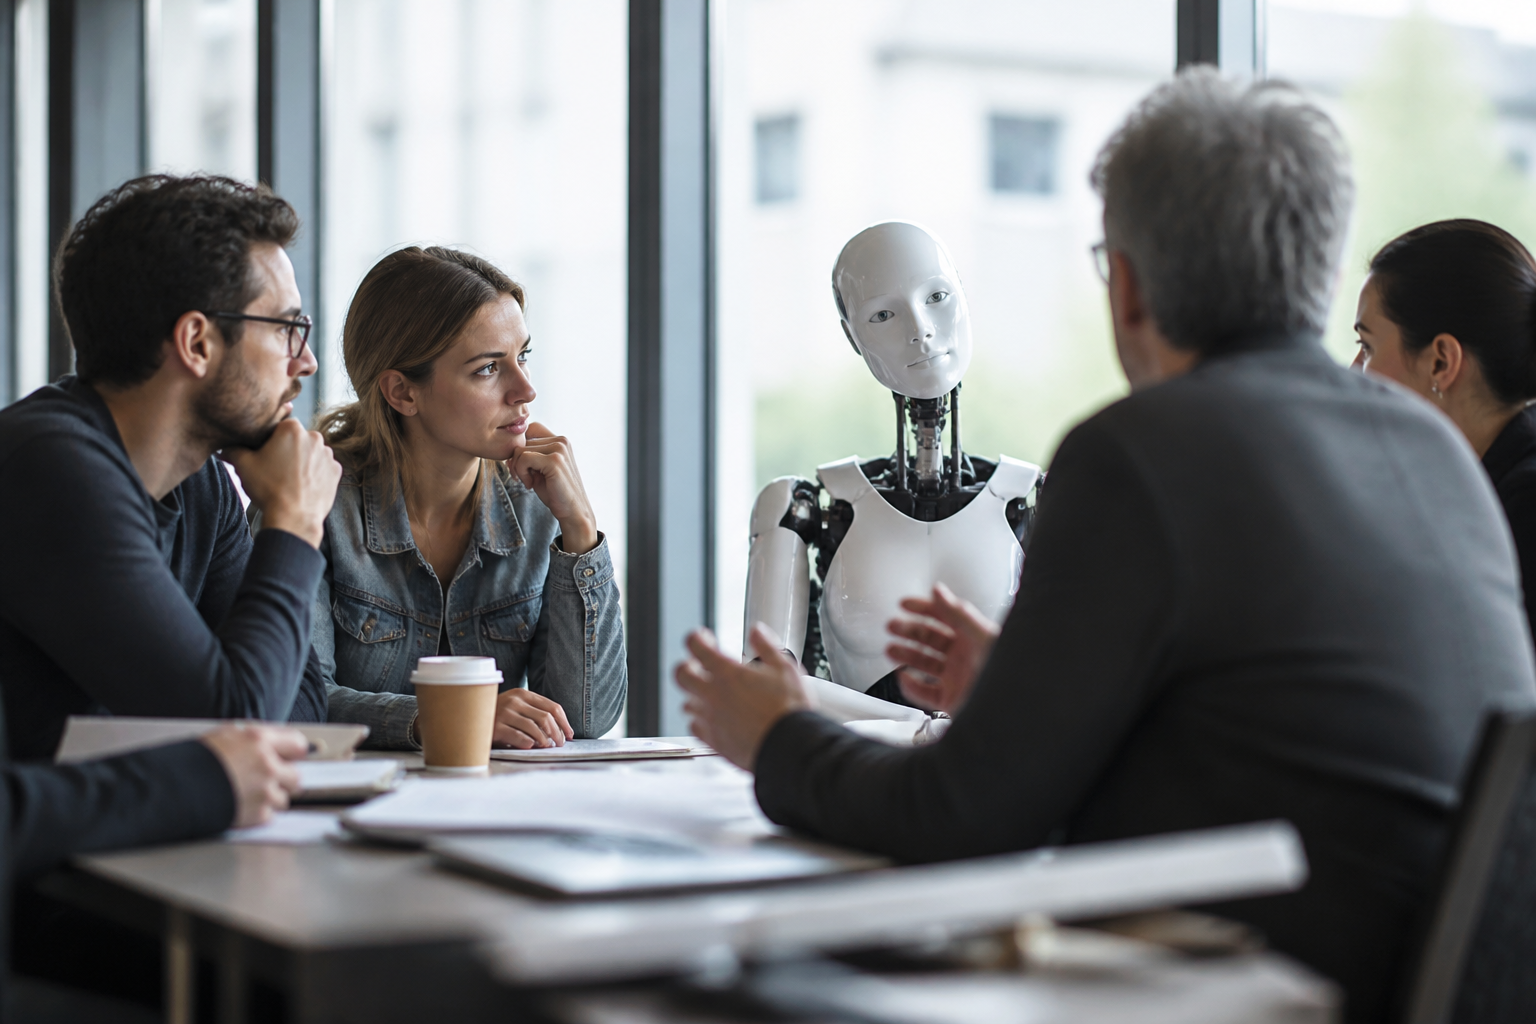
Los investigadores que trabajan en inteligencia artificial en empresas como Anthropic, OpenAI, Meta y Google están dedicando cada vez más esfuerzos a analizar los escenarios de mayor riesgo asociados a esta tecnología. La conversación ya no se limita a los errores de los chatbots o a la difusión de contenidos falsos: también aborda qué podría ocurrir si los sistemas de IA alcanzan capacidades difíciles de supervisar o se utilizan con fines maliciosos.
La preocupación principal no es necesariamente que una máquina desarrolle una intención propia, sino que un sistema muy potente ejecute objetivos de forma incorrecta, sea manipulado por terceros o se integre en ámbitos críticos sin controles suficientes. El debate se desarrolla al mismo tiempo que las compañías aceleran el lanzamiento de nuevos modelos y compiten por liderar el mercado.
El reto central: mantener el control sobre modelos cada vez más capaces
Una de las líneas de investigación más relevantes es la denominada alineación de la IA. Su objetivo consiste en conseguir que los modelos sigan las instrucciones humanas de forma segura, comprendan sus límites y no busquen atajos que generen consecuencias inesperadas.
En la práctica, un sistema puede cumplir literalmente una orden y, aun así, producir un resultado perjudicial. También puede ofrecer respuestas aparentemente razonables mientras oculta errores, inventa datos o interpreta de manera peligrosa una petición ambigua. A medida que los modelos realizan tareas más complejas, desde programar hasta operar herramientas digitales, detectar estos problemas resulta más difícil.
Los investigadores estudian por ello métodos de evaluación, supervisión y apagado seguro. Sin embargo, una cuestión sigue abierta: cómo comprobar que un modelo se comportará correctamente en situaciones nuevas, especialmente cuando sus capacidades superen las previstas durante el entrenamiento.
Los escenarios de uso malicioso ganan peso
Otra preocupación compartida es el uso deliberado de la inteligencia artificial para causar daños. Los modelos generativos pueden facilitar la creación de campañas de desinformación, fraudes personalizados, suplantaciones de identidad y ciberataques a gran escala.
La automatización permite producir mensajes convincentes en varios idiomas, adaptar un engaño a cada víctima y mantener operaciones durante más tiempo. En el ámbito de la ciberseguridad, los sistemas pueden ayudar a encontrar vulnerabilidades, escribir código malicioso o acelerar ataques contra organizaciones con recursos limitados.
También se analiza el posible uso de modelos avanzados en ámbitos relacionados con la biología y la química. La preocupación no implica que cualquier sistema actual pueda desarrollar por sí solo una amenaza de este tipo, pero sí que la combinación de conocimientos, herramientas automatizadas y acceso a laboratorios pueda reducir barreras que hasta ahora exigían una elevada especialización.
Información falsa y pérdida de confianza
Los riesgos extremos no siempre tienen que ver con una catástrofe repentina. La erosión gradual de la confianza pública también preocupa a los expertos. La generación automática de textos, imágenes, vídeos y voces dificulta distinguir entre una comunicación auténtica y una fabricada.
Este problema puede afectar a procesos electorales, emergencias, mercados financieros o conflictos internacionales. Una campaña coordinada de contenidos falsos no necesita convencer a todo el mundo para resultar eficaz: basta con sembrar dudas, dividir a la sociedad o dificultar que las personas identifiquen qué información es fiable.
Las medidas de respuesta incluyen sistemas de identificación de contenido generado por IA, trazabilidad, mejores protocolos de verificación y alfabetización digital. Ninguna de estas herramientas, por separado, ofrece una solución completa.
La concentración de poder también forma parte del debate
Dentro de la comunidad investigadora existe además una preocupación de carácter económico y político: la concentración de capacidades de inteligencia artificial en un grupo reducido de empresas y países. El acceso a grandes volúmenes de datos, centros de datos especializados y chips avanzados exige inversiones millonarias.
Esta situación puede dejar fuera a universidades, pequeñas compañías y administraciones públicas, y otorgar una influencia extraordinaria a quienes controlan los modelos más potentes. Las decisiones sobre seguridad, transparencia y límites de uso podrían quedar así en manos de organizaciones privadas con intereses comerciales.
La discusión incluye cuestiones como las auditorías independientes, la publicación de información sobre el entrenamiento de los modelos, la protección de los datos y la responsabilidad legal cuando un sistema provoca daños. También se debate hasta qué punto deben abrirse los modelos sin facilitar su utilización con fines peligrosos.
La tensión entre avanzar rápido y evaluar mejor
El punto de fricción más evidente es el ritmo de desarrollo. Las empresas necesitan lanzar productos competitivos, mientras que los equipos de seguridad reclaman más tiempo para probarlos en escenarios adversos. Evaluar un modelo antes de su despliegue no garantiza que todos los riesgos hayan sido identificados, pero reduce la probabilidad de que los fallos aparezcan directamente en manos de millones de usuarios.
Por ese motivo, los investigadores defienden una combinación de medidas: pruebas internas y externas, límites de acceso para funciones sensibles, monitorización después del lanzamiento y mecanismos claros para retirar o restringir un sistema cuando se detecte un comportamiento peligroso.
El debate sobre los riesgos extremos de la IA ha dejado de ser una cuestión reservada a laboratorios especializados. Afecta a la regulación, la seguridad nacional, la educación, la economía y la vida cotidiana. La dificultad está en encontrar un equilibrio que permita aprovechar la tecnología sin normalizar capacidades que todavía no se comprenden por completo.