La inteligencia artificial entra en la era del enrutamiento entre modelos
La inteligencia artificial afronta una nueva etapa de madurez: ya no se trata únicamente de elegir el modelo más potente, sino de decidir qué modelo debe responder a cada petición. Las plataformas de enrutamiento entre modelos permiten analizar una tarea en tiempo real y dirigirla hacia el sistema más adecuado según su dificultad, coste, velocidad o nivel de precisión.
Este cambio introduce una lógica más flexible en el uso de la IA generativa. Una misma aplicación puede recurrir a un modelo avanzado para resolver una consulta compleja, utilizar una opción más económica para resumir un texto y seleccionar una alternativa especializada cuando necesita programar, traducir o interpretar imágenes.
Del modelo único a una estrategia inteligente
Hasta ahora, muchas empresas construían sus servicios alrededor de un único proveedor o de un modelo principal. Esta configuración simplificaba la integración, pero también generaba dependencia y obligaba a pagar el precio de la opción elegida incluso cuando la tarea no requería tanta capacidad.
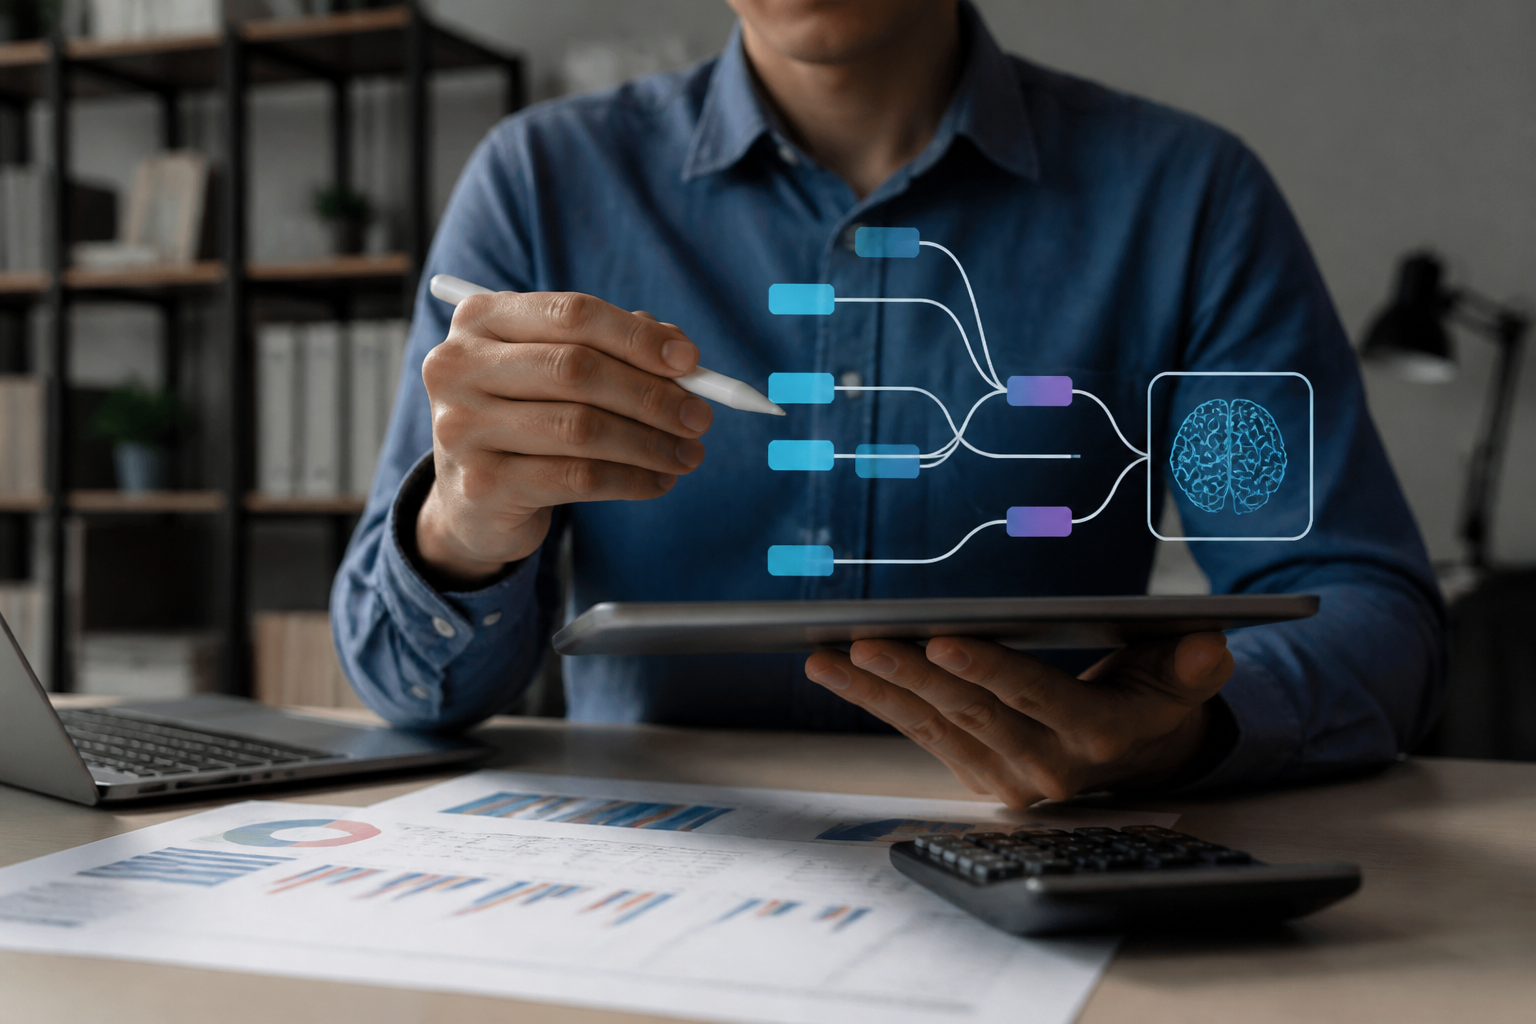
El enrutamiento cambia ese planteamiento. En lugar de enviar todas las solicitudes al mismo destino, una capa intermedia evalúa cada entrada y determina cuál es la respuesta más conveniente. Puede tener en cuenta el tipo de pregunta, la longitud del contenido, el idioma, la urgencia o el historial de la conversación.
El resultado es una arquitectura capaz de combinar distintos modelos sin que el usuario tenga que conocer qué sistema ha intervenido. Para las compañías, esta flexibilidad puede traducirse en una mejor experiencia y en un control más preciso de los recursos tecnológicos.
El coste se convierte en una variable estratégica
La expansión de la IA ha puesto el consumo de recursos en el centro de las decisiones empresariales. Cada consulta tiene un coste asociado, que puede variar según el modelo empleado, la cantidad de información procesada y la modalidad de respuesta. Cuando el volumen de peticiones crece, pequeñas diferencias por solicitud pueden convertirse en partidas relevantes.
Las plataformas de enrutamiento permiten reservar los modelos más caros para los casos que realmente lo necesitan. Una petición sencilla puede ser atendida por una opción rápida y económica, mientras que una solicitud crítica o especialmente compleja se deriva a un modelo con mayor capacidad de razonamiento.
El objetivo no es pagar menos en todos los casos, sino obtener la mejor relación entre coste y resultado. Esta distinción es importante para sectores como la atención al cliente, el comercio electrónico, las finanzas o la gestión documental, donde una aplicación puede procesar miles o millones de interacciones.
Más velocidad y disponibilidad para las aplicaciones
El enrutamiento también puede mejorar el rendimiento. Si un modelo está saturado, el sistema puede enviar la petición a otra alternativa compatible. Del mismo modo, una plataforma puede priorizar aquellos servicios que ofrecen menor latencia cuando la respuesta debe producirse en tiempo real.
Esta capacidad resulta especialmente útil en asistentes virtuales, herramientas de soporte y aplicaciones integradas en procesos empresariales. Una respuesta ligeramente más sencilla, pero inmediata, puede ser más útil que otra técnicamente superior que tarde demasiado en llegar.
La redundancia entre proveedores añade además una capa de continuidad. Ante una interrupción, un cambio de precios o una limitación de capacidad, la organización puede mantener el servicio activo mediante otro modelo. Aun así, esta ventaja exige comprobar previamente que las alternativas ofrecen un nivel de calidad y unas condiciones de uso compatibles.
Cómo decide el enrutador qué modelo utilizar
La selección puede basarse en reglas definidas por la empresa o en sistemas capaces de clasificar automáticamente las solicitudes. En una configuración básica, el administrador establece criterios como el idioma, la longitud del texto o el tipo de usuario. En opciones más avanzadas, el propio sistema estima la complejidad de la petición y escoge el modelo más apropiado.
- Complejidad: las tareas que requieren razonamiento avanzado pueden dirigirse a modelos de mayor capacidad.
- Coste: las consultas rutinarias pueden resolverse con alternativas más asequibles.
- Velocidad: las aplicaciones en tiempo real pueden priorizar modelos con menor latencia.
- Especialización: una petición de código, análisis de documentos o generación de imágenes puede utilizar servicios concretos.
- Disponibilidad: el sistema puede activar rutas alternativas cuando un proveedor presenta problemas.
Para que esta estrategia funcione, no basta con medir el precio. También es necesario evaluar la calidad de las respuestas, la tasa de errores, la capacidad de seguir instrucciones y el comportamiento ante información sensible.
Los retos de la nueva arquitectura
La principal dificultad es mantener una experiencia coherente. Dos modelos pueden interpretar de forma distinta una misma instrucción, utilizar estilos diferentes o entregar resultados con un nivel desigual de precisión. Por eso, las empresas deben definir criterios de evaluación y comprobar de forma continua el rendimiento de cada ruta.
La privacidad es otro aspecto esencial. La información enviada a un modelo puede atravesar infraestructuras y jurisdicciones diferentes, de modo que el enrutador debe aplicar políticas claras sobre datos personales, contenidos confidenciales y requisitos regulatorios.
También aumenta la complejidad operativa. Gestionar varios proveedores implica controlar claves de acceso, contratos, límites de uso, registros y cambios en las versiones de los modelos. Sin herramientas de observabilidad, resulta difícil saber qué sistema ha generado una respuesta, cuánto ha costado o por qué se ha producido un fallo.
Una capa de decisión para la IA empresarial
El enrutamiento entre modelos apunta a convertirse en una pieza habitual de las plataformas de inteligencia artificial. Su función no consiste solo en conectar servicios, sino en crear una capa de decisión capaz de equilibrar calidad, coste, velocidad y seguridad.
Para los usuarios, esta evolución será prácticamente invisible. Para las organizaciones, en cambio, puede marcar la diferencia entre desplegar una herramienta experimental y operar un sistema de IA sostenible a gran escala. La pregunta ya no será qué modelo es el mejor en términos absolutos, sino cuál es el más adecuado para cada tarea y en cada momento.