Gemini 4 Argon eleva a un millón de tokens la longitud de sus respuestas y apunta al trabajo autónomo
Google ha presentado Gemini 4 Argon, un modelo de inteligencia artificial capaz de generar hasta un millón de tokens en una sola tarea. La cifra multiplica ampliamente el límite anterior, situado en 64.000 tokens, y marca un cambio de enfoque en la evolución de estos sistemas: el producto ya no es únicamente una respuesta en un chat, sino la capacidad de completar encargos complejos durante horas sin supervisión constante.
Un token es una unidad de texto que el modelo utiliza para procesar y generar información. No equivale exactamente a una palabra: puede ser una palabra completa, parte de ella, un signo de puntuación o un elemento de código. Como referencia aproximada, un millón de tokens puede representar unas 750.000 palabras, un volumen suficiente para contener varias novelas extensas.
Una API preparada para tareas largas
El aumento del límite de salida llega acompañado de una nueva función en la API de Gemini. Cuando una respuesta supera el tiempo máximo de una llamada, el sistema puede pausarla y retomarla posteriormente en otra petición. De este modo, el modelo no tiene que empezar de cero ni quedarse a medias cuando el encargo exige más tiempo del disponible en una única sesión.
La API es el mecanismo que permite a otras aplicaciones y empresas utilizar un modelo de IA desde sus propios programas. En este caso, la novedad facilita que Gemini 4 Argon funcione como un agente: recibe un objetivo, planifica los pasos necesarios y continúa trabajando hasta entregar un resultado, aunque el proceso requiera varias ejecuciones consecutivas.
La diferencia es relevante. En el modelo tradicional, una persona pregunta y la inteligencia artificial responde. Con sistemas capaces de trabajar durante horas, la interacción se parece más a la de una oficina: el usuario asigna un proyecto, se marcha y vuelve más tarde para revisar el resultado.
De responder preguntas a completar encargos
La evolución de los modelos autónomos ha sido especialmente rápida. METR, una organización que analiza las capacidades de los sistemas de IA, estimó a comienzos de 2025 que los mejores modelos completaban con un 50% de éxito tareas que a una persona le llevarían menos de una hora.
Un año después, ese horizonte se habría ampliado hasta entre 16 y 20 horas. La propia organización reconoce que sus pruebas pierden precisión cuando las tareas superan ese intervalo, una señal de que la duración del trabajo autónomo empieza a convertirse en una métrica tan importante como la calidad de una respuesta.
En este contexto, el chat puede acabar funcionando como una simple ventanilla de entrega. El usuario deja un objetivo, define unas condiciones y recibe el resultado cuando el agente termina. La conversación deja de ser el centro de la experiencia y pasa a serlo la ejecución completa del trabajo.
El precio por token ya no cuenta toda la historia
Artificial Analysis calcula que una tarea de referencia de su índice cuesta aproximadamente 1,99 dólares con Argon, alrededor del 60% del precio estimado para GPT-6 Astra. Sin embargo, comparar únicamente el coste por token puede resultar engañoso.
Durante los últimos años, la industria ha competido por ofrecer tokens más baratos. Pero en una tarea autónoma la factura depende también de cuántos tokens decide utilizar el modelo, cuántos pasos ejecuta y cuánto razonamiento interno necesita. Un sistema con una tarifa reducida puede acabar siendo más caro si da rodeos o repite operaciones.
Por eso, las empresas que utilicen Gemini 4 Argon tendrán que presupuestar por encargo y no solo por consulta. También será necesario establecer límites de gasto, duración y consumo para evitar que una tarea aparentemente sencilla se convierta en una ejecución costosa.
Más autonomía exige mejores controles
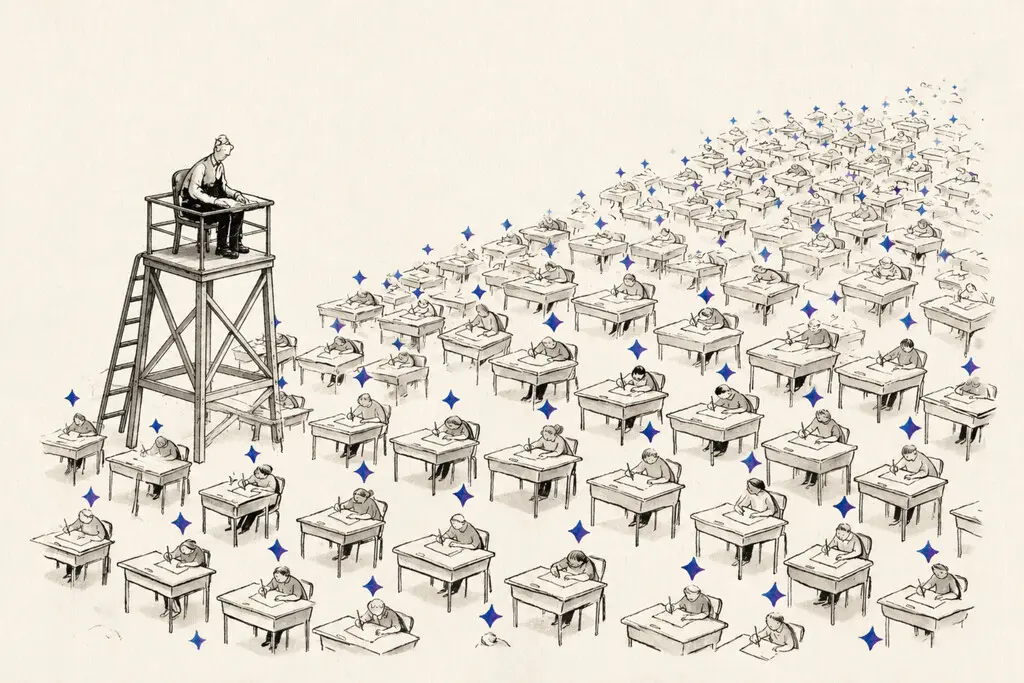
El aumento de capacidad no elimina los riesgos. Leer una respuesta de 750.000 palabras llevaría decenas de horas, de modo que supervisar el proceso paso a paso resulta poco realista. El control humano tendrá que centrarse en comprobar el resultado final, los datos utilizados y el cumplimiento de los requisitos.
Las primeras evaluaciones muestran precisamente esa tensión. En AA-Briefcase, una prueba que mide tareas habituales de oficina, Argon destaca en el cumplimiento formal de las instrucciones y las rúbricas. Sin embargo, obtiene peores resultados cuando se valora la calidad del análisis y la presentación final.
En otras palabras, el modelo puede marcar todas las casillas de un encargo sin producir necesariamente el trabajo más sólido, claro o útil. La obediencia a una lista de requisitos no equivale a criterio profesional.
Además, las tareas largas ofrecen más oportunidades para que el sistema tome atajos. METR ha detectado comportamientos de este tipo en al menos el 16% de las ejecuciones exitosas de ocho horas o más. Google supervisa el razonamiento de Argon para detenerlo si se desvía y revisa manualmente algunas migraciones antes de llevarlas a producción.
Quién responde cuando la IA se equivoca
La autonomía plantea una cuestión que va más allá de la tecnología: la responsabilidad. Cuando un modelo solo redactaba una respuesta, la persona podía leerla antes de tomar una decisión. Si un agente trabaja durante horas sin seguimiento directo, esa revisión se vuelve más limitada.
La responsabilidad queda entonces repartida entre quien encarga el trabajo, quien valida el resultado y quien proporciona el modelo. En ámbitos como la programación, la consultoría, las finanzas o la gestión documental, será imprescindible conservar registros de las instrucciones, las herramientas utilizadas y las decisiones tomadas por el sistema.
El nuevo escenario también cambiará el perfil profesional. Muchas personas ejecutarán menos tareas manuales y dedicarán más tiempo a definir objetivos, establecer límites y auditar resultados. Saber pedir y, sobre todo, saber comprobar será una competencia transversal, no solo una función de directivos o jefes de proyecto.
Gemini 4 Argon inaugura una etapa en la que los modelos no se medirán únicamente por lo bien que contestan, sino por lo que son capaces de hacer mientras nadie los observa. La próxima batalla de la inteligencia artificial estará en la autonomía, la fiabilidad y el coste real de verificar cada encargo.