GPT-6, Claude y Grok se enfrentan a un Toyota Corolla: 8 de 11 intentos acabaron en colisión antes de la primera curva
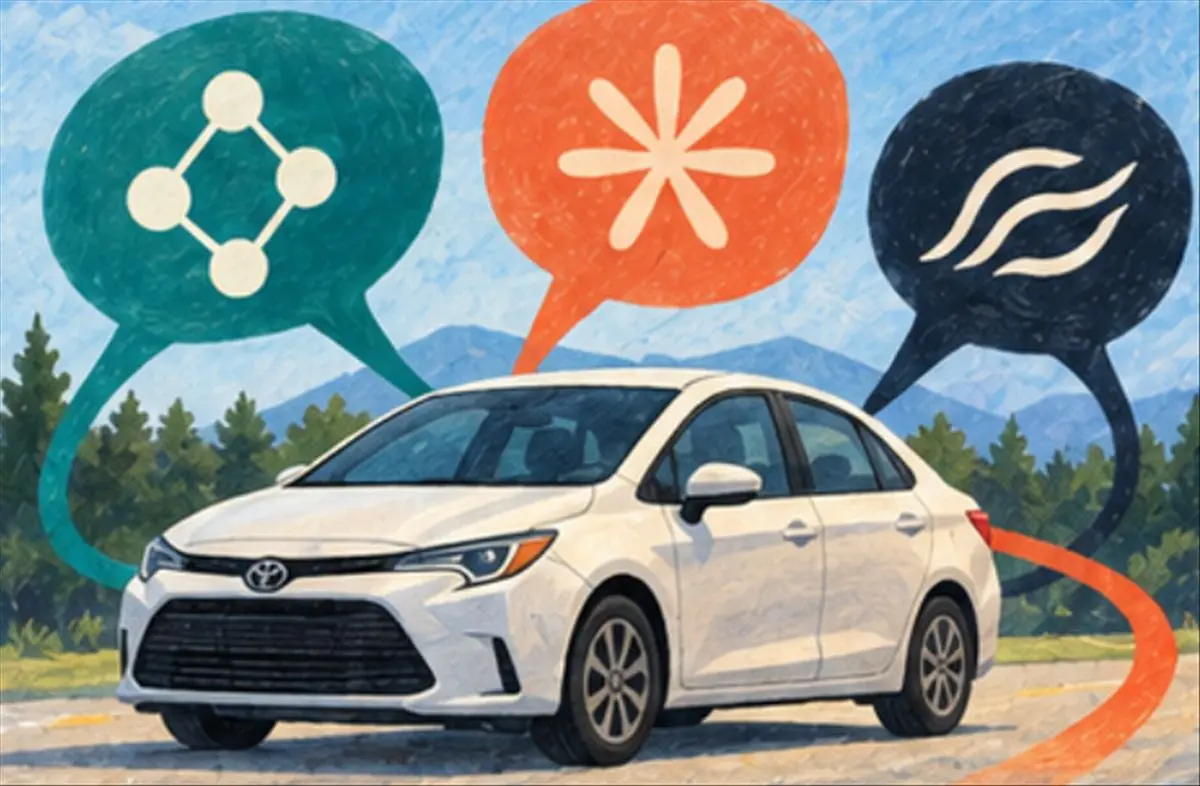
Los agentes de inteligencia artificial de propósito general todavía están lejos de desenvolverse con solvencia en el mundo físico. Así lo plantea DrivingBench, un experimento en el que varios sistemas de IA intentaron conducir un Toyota Corolla real equipado con tecnología de visión de Comma y OpenPilot.
Ocho de los 11 intentos realizados terminaron en una colisión antes de superar la primera curva del circuito. Solo uno de los agentes logró completar el recorrido, y lo hizo en su segundo intento, con un coste de 7,74 dólares, aproximadamente 7,28 euros. No se registraron heridos durante las pruebas.
Un circuito sencillo para medir un problema complejo
DrivingBench fue diseñado por los investigadores Aditya Ramabadran, Simon Mahns y Tobias Gessler para evaluar hasta qué punto los agentes de IA actuales pueden trasladar sus capacidades del entorno digital al mundo físico.
La prueba se desarrolló en un aparcamiento. Varios conos delimitaban una ruta corta entre un punto de salida y otro de llegada, con una primera curva como principal obstáculo. El vehículo recibía información visual a través del hardware instalado en el coche y enviaba sus decisiones en forma de comandos de conducción.
Los agentes operaban de forma remota. Las instrucciones se transmitían mediante un punto de acceso inalámbrico a centros de datos, donde se procesaban las imágenes y se generaban las órdenes para el automóvil. Ese sistema introducía una latencia, es decir, un retraso entre la percepción de la escena y la respuesta del vehículo.
Como consecuencia, el Corolla tenía que detenerse con frecuencia para que el agente analizara la nueva información y decidiera el siguiente movimiento. El diseño era deliberadamente básico, pero permitía observar con claridad los límites de estos modelos cuando deben actuar sobre objetos, distancias y movimientos reales.
GPT-6 Astra fue el único agente que completó el recorrido
En total se probaron cuatro agentes distintos, entre ellos GPT-6 Astra, Claude y Grok. La mayoría de los intentos fallidos acabó dentro del primer 11% del trayecto, prácticamente en la primera curva.
GPT-6 Astra se detuvo a mitad del recorrido durante su primera prueba, pero consiguió completar el circuito en el segundo intento. El éxito tuvo un coste de 7,74 dólares, casi cuatro veces superior al del intento anterior, según los datos del experimento.
El resultado demuestra que un agente puede llegar a resolver la tarea, pero también evidencia que hacerlo requiere un consumo de recursos y un nivel de incertidumbre que no serían aceptables para una aplicación de conducción real.
Errores de percepción y razonamiento espacial
Uno de los fallos más llamativos correspondió a Grok. El sistema interpretó el espacio entre dos conos como una puerta o un punto de paso válido y dirigió el vehículo hacia uno de ellos después de apenas dos comandos.
El problema no fue únicamente de control del volante. El agente parecía haber identificado correctamente que existía un hueco, pero no entendió su función dentro del recorrido. En otras palabras, detectó la apertura entre dos objetos, pero no relacionó esa información con el hecho de que los conos estaban delimitando el carril.
Otro agente basado en GPT inventó una regla sobre el significado de los colores de los conos y modificó su estrategia a partir de esa suposición. En un entorno de texto, este fenómeno se conoce como alucinación: la generación de información falsa presentada como si fuera cierta. En un vehículo, una inferencia de este tipo puede traducirse directamente en una maniobra peligrosa.
El error más habitual fue calcular mal el ángulo necesario para superar la primera curva. Los modelos de lenguaje pueden describir qué significa girar de forma pronunciada, pero convertir esa descripción en grados concretos de volante, teniendo en cuenta la perspectiva de una cámara y el movimiento del coche, exige una comprensión física mucho más precisa.
El abismo entre los agentes digitales y el mundo físico
Los agentes de IA son sistemas capaces de recibir instrucciones, utilizar herramientas y ejecutar acciones en nombre del usuario. En aplicaciones como procesadores de texto, hojas de cálculo o presentaciones suelen desenvolverse con mayor solvencia porque trabajan en un entorno simbólico: manipulan palabras, cifras, menús y comandos.
Conducir exige algo diferente. El sistema debe mantener una representación actualizada del espacio, anticipar trayectorias, estimar distancias y reaccionar en tiempo real. Además, sus decisiones tienen consecuencias físicas y no siempre pueden deshacerse.
Esta diferencia cuestiona la idea de que basta con añadir herramientas y acceso a sistemas externos para convertir un modelo de lenguaje en un agente capaz de actuar eficazmente en cualquier contexto. El denominado anclaje físico, la conexión entre las palabras del modelo y los objetos y fuerzas del mundo real, continúa siendo una de las principales barreras.
DrivingBench no pretende demostrar que los agentes de IA sean incapaces de conducir, sino mostrar que las demostraciones digitales no deben confundirse con una autonomía física fiable. Completar una ruta corta en un aparcamiento es un primer paso, pero los resultados sugieren que queda un largo camino hasta alcanzar la precisión, la seguridad y la rapidez necesarias para tareas reales.