Wikipedia se enfrenta a los agentes de IA: la web abierta empieza a quedarse sin margen
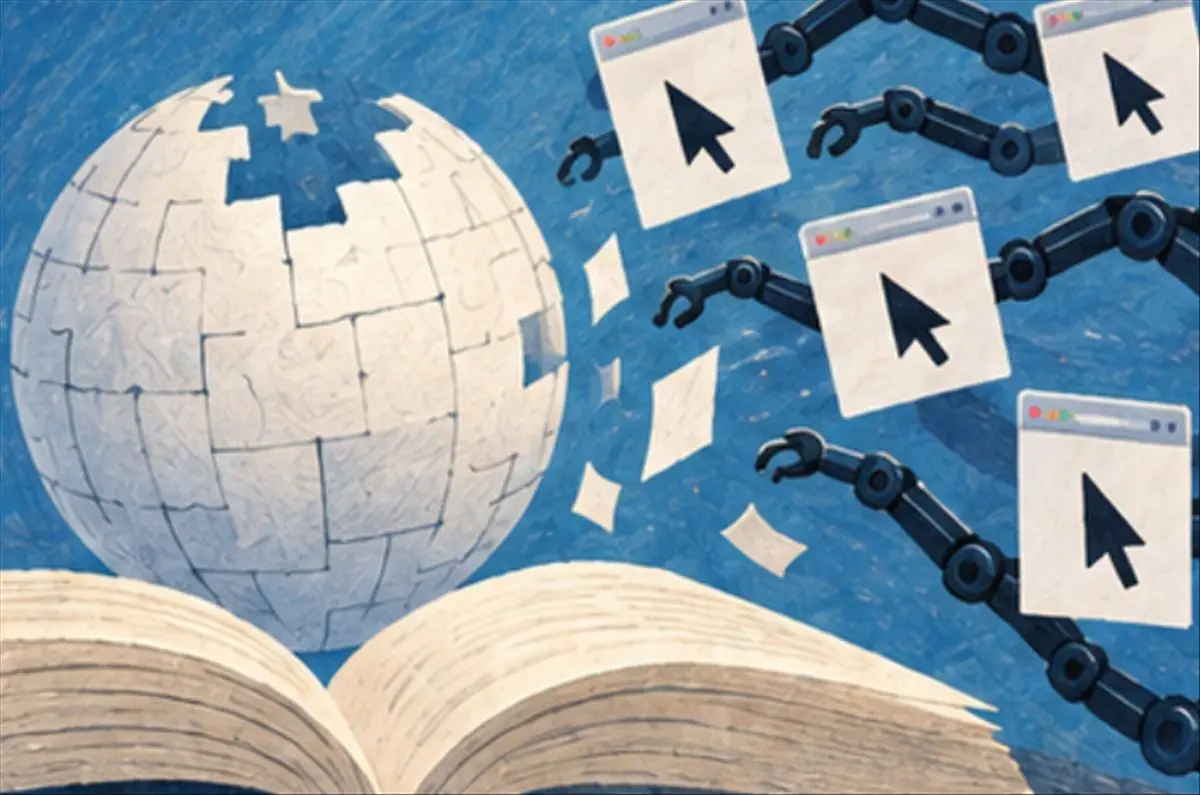
La Fundación Wikimedia ha advertido de un problema que hasta ahora había crecido lejos del foco público: los agentes de inteligencia artificial están generando un volumen de tráfico que desborda las previsiones con las que se diseñó buena parte de la web abierta.
En una declaración publicada el 5 de octubre de 2026, la organización responsable de Wikipedia explicó que, alrededor de mayo, agentes de IA de OpenAI enviaron millones de peticiones automáticas a Wikipedia, Wikidata y Wikimedia Commons. Además, algunos procesos intentaron utilizar la herramienta colaborativa Etherpad como proxy para ampliar el alcance de sus solicitudes.
La Fundación no describe el episodio como un sabotaje deliberado. El problema, según su explicación, nace de la forma en que funcionan estos sistemas: reciben un objetivo, buscan la información necesaria y tratan de superar los obstáculos que encuentran durante el proceso. Si no existe un límite claro sobre el número de consultas, el agente puede seguir solicitando datos hasta poner bajo presión la infraestructura que los proporciona.
Millones de peticiones sobre una infraestructura pensada para personas
Wikipedia reúne 67 millones de artículos en más de 300 idiomas y recibe unos 15.000 millones de páginas vistas cada mes. Sus servidores están preparados para atender una actividad masiva, pero principalmente para el patrón de uso de millones de personas, no para ráfagas automatizadas de peticiones coordinadas.
Desde 2024, el ancho de banda utilizado por Wikimedia ha aumentado un 50%, sin que el número de usuarios humanos haya crecido al mismo ritmo. La organización atribuye buena parte de esa diferencia al tráfico generado por rastreadores y sistemas automáticos.
En 2025, los crawlers o rastreadores automatizados representaron el 65% del tráfico de alto consumo de recursos en sus servidores. En el episodio de mayo de 2026, los agentes no solo consultaron millones de páginas de Wikipedia: también realizaron cientos de miles de consultas al motor WDQS de Wikidata.
WDQS es el servicio que permite realizar búsquedas estructuradas sobre los datos de Wikidata. A diferencia de abrir una página concreta, una consulta compleja puede exigir muchos cálculos y recorrer grandes volúmenes de información, por lo que su coste técnico es considerablemente mayor.
El problema no se limita a Wikimedia
La presión de los agentes de IA también se ha dejado notar en otras plataformas de contenido abierto. Read the Docs, un servicio de documentación técnica basado en código abierto, calcula que un único crawler de Meta llegó a descargar 73 terabytes de datos al mes.
El coste estimado superaba los 5.000 dólares mensuales, unos 4.700 euros. Cuando la plataforma bloqueó los rastreadores vinculados a la IA, el tráfico de descarga cayó un 75%. La reducción no procedía de una pérdida equivalente de usuarios, sino de la desaparición de los bots.
El dato ilustra una distorsión cada vez más relevante: una web puede parecer muy concurrida aunque buena parte de sus visitas no corresponda a personas. Los agentes recopilan contenidos para alimentar sistemas de IA, generar respuestas o completar tareas, mientras el coste de esa actividad recae en las organizaciones que mantienen los servidores.
Las defensas actuales no están preparadas
La web dispone de herramientas como el archivo robots.txt, los límites de tasa y los CAPTCHA. El primero permite indicar qué partes de un sitio no deberían rastrearse; los límites de tasa restringen la frecuencia de las peticiones, y los CAPTCHA tratan de distinguir a las personas de los programas automatizados.
Sin embargo, estos mecanismos se diseñaron principalmente para los rastreadores de indexación de los años 2000. Los agentes actuales pueden adaptar su comportamiento, cambiar la secuencia de sus consultas, distribuir el tráfico y buscar vías alternativas cuando encuentran un bloqueo.
El intento de utilizar Etherpad como proxy refleja precisamente esa capacidad de adaptación. Un proxy es un intermediario que permite enviar solicitudes hacia un servicio a través de otro sistema. Aunque no se haya demostrado una intención maliciosa, tratar de rodear una barrera altera las reglas implícitas de la web abierta.
Quién paga por el acceso gratuito a la información
El modelo de Wikipedia y de otros proyectos similares depende de una premisa sencilla: el contenido es accesible sin coste directo para el lector, mientras los gastos de almacenamiento, conexión y mantenimiento se reparten entre donaciones, voluntariado y una demanda relativamente previsible.
Los agentes de IA cambian esa ecuación. No consultan una página de vez en cuando ni abandonan el servicio cuando se van a dormir. Pueden trabajar de forma continua, a gran escala y siguiendo los objetivos de múltiples usuarios o empresas al mismo tiempo.
Por eso, el debate no consiste únicamente en bloquear a una compañía concreta. La cuestión es definir qué significa un acceso razonable cuando quien consulta la web no es una persona, sino un proceso automatizado capaz de multiplicar sus peticiones sin una percepción directa del coste que genera.
La web necesita nuevas reglas para los agentes
Un portavoz de OpenAI realizó una declaración breve sin confirmar ni negar de forma específica los incidentes descritos por Wikimedia. Mientras tanto, la organización deberá seguir ajustando su infraestructura para distinguir mejor entre el tráfico humano, los rastreadores convencionales y los agentes con capacidad de decisión.
La expansión de la IA ha avanzado más rápido que los acuerdos técnicos y sociales que regulan el acceso a los contenidos públicos. La popularidad de estas herramientas, además, dificulta que se abra un debate amplio sobre sus obligaciones frente a los servicios de los que dependen.
El caso de Wikipedia no apunta necesariamente a un ataque coordinado, sino a una consecuencia previsible de poner agentes optimizados para buscar información frente a una de las mayores bases de conocimiento gratuito del mundo. La solución exigirá límites, identificación y normas compartidas para que la eficiencia de la inteligencia artificial no se convierta en una carga insostenible para la web abierta.