Microsoft presenta Maia 300, el chip propio que quiere multiplicar por siete su capacidad de inferencia de IA
Microsoft ha presentado Maia 300, su segunda generación de chips diseñados internamente para ejecutar modelos de inteligencia artificial en sus centros de datos. La compañía asegura que el nuevo acelerador ofrece hasta siete veces más rendimiento en inferencia que Maia 200 y un 40% más de eficiencia en el procesamiento de tokens por megavatio.
El lanzamiento forma parte de la estrategia de Microsoft para reducir su dependencia de las GPU de Nvidia, especialmente en los servicios que funcionan sobre Azure. La empresa prevé comenzar el despliegue de Maia 300 en 2027 y aspira a llevar su infraestructura de IA hasta una escala de varios gigavatios de potencia.
Un chip pensado para ejecutar modelos, no para entrenarlos
Maia 300 está diseñado principalmente para la inferencia. En inteligencia artificial, este término describe la fase en la que un modelo ya entrenado responde a las peticiones de los usuarios: generar texto, resumir documentos, crear código o analizar imágenes, por ejemplo.
El entrenamiento, en cambio, es el proceso inicial en el que el modelo aprende a partir de grandes cantidades de datos. Esa tarea suele requerir una capacidad de cálculo y una interconexión entre chips especialmente elevadas. Microsoft mantiene, por tanto, la dependencia de aceleradores de propósito general para una parte importante del entrenamiento de modelos grandes.
La inferencia tiene unas exigencias distintas. Debe ofrecer respuestas rápidas y hacerlo con el menor coste energético posible, sobre todo cuando los servicios atienden a cientos de millones de usuarios. En este contexto, Microsoft busca que Maia 300 convierta una mayor proporción de la electricidad consumida en capacidad real para sus aplicaciones de IA.
Racks de 96 chips y 167 kilovatios de consumo
La compañía ha diseñado un rack completo con 96 unidades Maia 300. Este sistema alcanza un consumo de 167 kilovatios y está orientado a los grandes clústeres de computación que sostienen servicios como Azure OpenAI, Microsoft Copilot y los modelos propios de la compañía.
La especificación técnica incluye ocho módulos de memoria HBM4 por nodo, frente a los dos módulos empleados por Maia 200. La memoria HBM, siglas de High Bandwidth Memory, permite transferir grandes volúmenes de datos a gran velocidad y es esencial para alimentar los modelos de IA sin que el procesador tenga que esperar continuamente a recibir información.
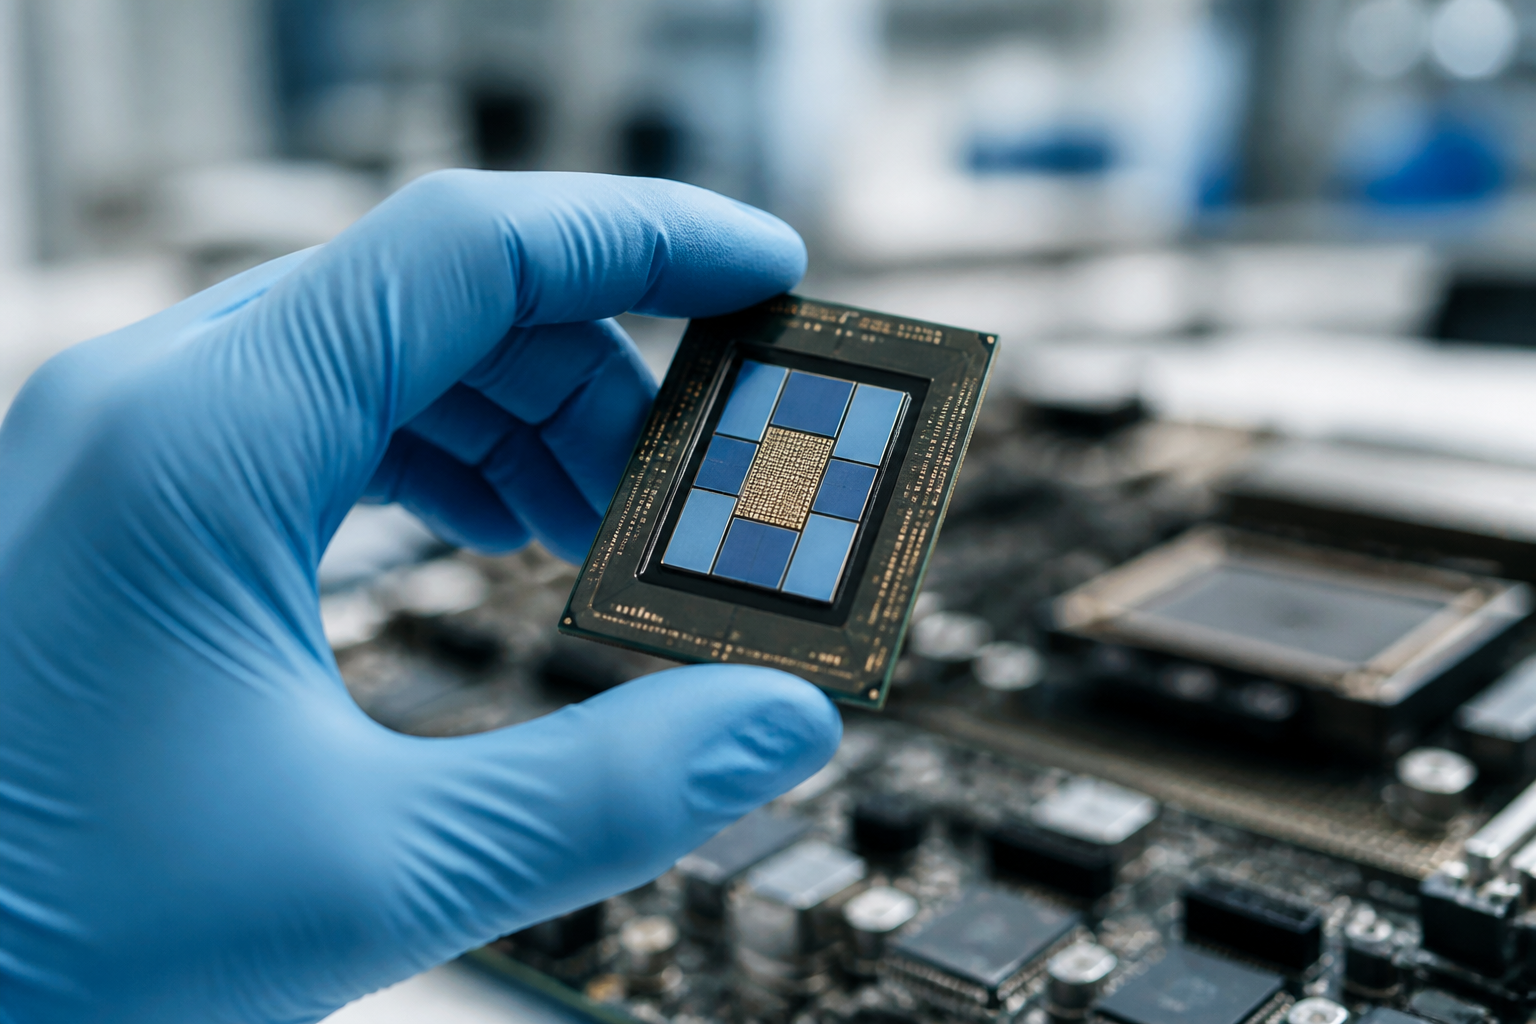
Maia 300 también utiliza un proceso de fabricación TSMC N2P y una arquitectura basada en chiplets interconectados. Los chiplets son bloques de silicio especializados que se combinan dentro de un mismo procesador. Este enfoque permite fabricar y conectar distintos componentes con mayor flexibilidad que un único chip monolítico, aunque también plantea retos de comunicación, refrigeración y fabricación.
Un despliegue de escala gigavatio para Azure
Microsoft prevé iniciar el despliegue de Maia 300 durante 2027 y ampliar progresivamente la capacidad hasta alcanzar una escala de gigavatios en sus centros de datos de Azure. Un gigavatio equivale a 1.000 megavatios, una magnitud que refleja tanto la dimensión de los clústeres de IA como la presión energética que afronta el sector.
La empresa ha comprometido alrededor de 80.000 millones de dólares, unos 75.200 millones de euros, para infraestructura de inteligencia artificial entre 2025 y 2027. Dentro de esa inversión se incluyen centros de datos, sistemas de refrigeración, redes de alta velocidad y aceleradores como Maia 300.
Si los objetivos de despliegue se cumplen, Microsoft podría llegar a instalar más de un millón de estos chips. La cifra modificaría de forma significativa la relación de la compañía con los fabricantes de GPU, aunque no supondría eliminar por completo la necesidad de recurrir a Nvidia.
Más capacidad de negociación frente a Nvidia
La estrategia de Microsoft no consiste necesariamente en sustituir todas las GPU externas, sino en disponer de una alternativa propia para una parte creciente de sus cargas de trabajo. Amazon ha seguido un camino similar con sus chips Trainium e Inferentia, mientras que Google lleva años desarrollando sus unidades de procesamiento tensorial, conocidas como TPU.
Contar con hardware propio puede reducir costes, facilitar la integración con el software de Azure y mejorar la previsibilidad del suministro. También proporciona a Microsoft una mayor capacidad de negociación a la hora de adquirir aceleradores destinados al entrenamiento, donde Nvidia continúa teniendo una posición dominante.
La compañía necesita además contener el coste de servicios como Copilot. La ejecución de cada consulta requiere recursos de computación y memoria, y ese gasto aumenta con el número de usuarios, la complejidad de las respuestas y el uso de modelos más avanzados. Una mejora del 40% en tokens procesados por megavatio podría ayudar a mantener la sostenibilidad económica de estas herramientas mientras amplían su base de clientes.
La competencia seguirá abierta
La principal incógnita es cómo se comportará Maia 300 frente a las próximas generaciones de aceleradores de Nvidia. Los modelos B200 y Rubin también incorporan memoria de alto ancho de banda y están orientados a mejorar la eficiencia de la inferencia. Por ello, las cifras anunciadas por Microsoft tendrán que comprobarse en cargas de trabajo reales y en comparación con sistemas equivalentes.
La ventaja de Maia 300 puede estar menos en superar universalmente a las GPU rivales que en su integración vertical. Microsoft controla el diseño del chip, el sistema operativo de sus centros de datos, Azure y buena parte del software que ejecuta sus modelos. Si esa combinación ofrece un coste por consulta inferior, la compañía podrá ampliar sus servicios de IA con mayor margen y menor exposición a la cadena de suministro de terceros.
En 2027, Nvidia seguirá siendo previsiblemente clave para entrenar modelos de gran tamaño. Maia 300 representa otra cosa: el intento de Microsoft de controlar una parte esencial de la fase de inferencia, justo la que determinará cuánto cuesta mantener la inteligencia artificial disponible a escala masiva.