Mac Studio M5 Ultra con 256 GB: el laboratorio de IA local que justifica, o no, más de 16.000 euros
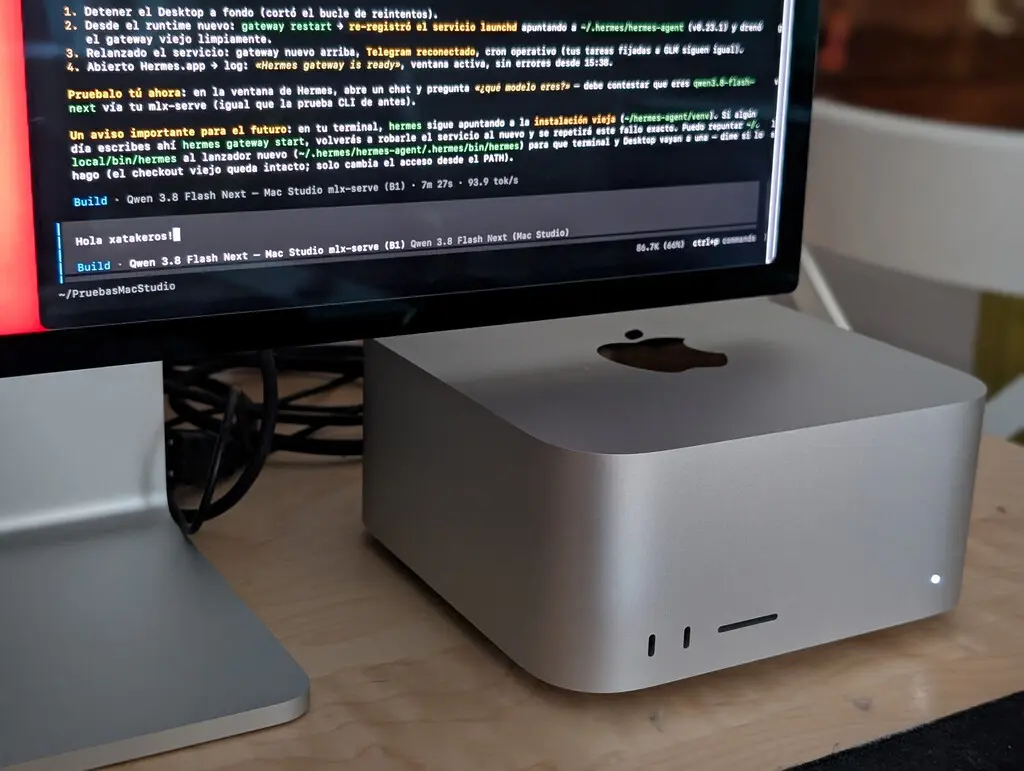
El Mac Studio con chip M5 Ultra y 256 GB de memoria unificada es una de las máquinas más potentes y caras que se pueden comprar hoy para trabajar con inteligencia artificial. Tras más de un mes de uso intensivo, la pregunta no es si puede ejecutar modelos locales, sino hasta dónde llega y para quién tiene sentido una inversión que supera los 16.000 euros.
El equipo ha sido probado específicamente como estación de trabajo para IA local, dejando en segundo plano tareas como la edición de vídeo o los videojuegos. El objetivo era medir qué modelos puede mover, con qué velocidad y qué ventajas ofrece frente a ordenadores más económicos, incluidos los PC equipados con tarjetas gráficas de consumo.
La alternativa a depender de la nube
Durante los últimos años, la forma más habitual de utilizar modelos como ChatGPT, Claude o Gemini ha sido acceder a ellos a través de una página web o de una herramienta de desarrollo. Cada petición se procesa en centros de datos externos y la respuesta vuelve al dispositivo en cuestión de segundos.
Este sistema resulta cómodo y permite acceder a modelos muy avanzados sin disponer de un ordenador potente. Sin embargo, también implica pagar por el uso, enviar los datos a un servicio externo y depender de condiciones que pueden cambiar: precios, límites, disponibilidad o políticas de privacidad.
La IA local plantea el enfoque contrario. El modelo se descarga y se ejecuta en el propio ordenador, sin necesidad de enviar cada consulta a un servidor. Los modelos abiertos actuales ya pueden programar, resumir documentos, traducir textos y resolver tareas de razonamiento con un nivel suficiente para determinados entornos profesionales.
Por qué importan tanto los 256 GB de memoria
El principal obstáculo para ejecutar modelos grandes no suele ser el procesador, sino la memoria necesaria para cargarlos. Los grandes modelos de lenguaje, conocidos como LLM, están formados por miles de millones de parámetros. Estos parámetros son valores numéricos que contienen lo aprendido durante el entrenamiento.
Un modelo de 27.000 millones de parámetros almacenado con una precisión de 16 bits puede ocupar alrededor de 54 GB. Para reducir ese tamaño se utiliza la cuantización, una técnica que representa los números con menos bits. El resultado es parecido a comprimir una imagen: se reduce el espacio necesario a cambio de una pequeña pérdida de precisión.
Con una cuantización de cuatro bits, un modelo como Qwen3.8-27B puede ocupar aproximadamente entre 17 y 18 GB. Esta técnica permite utilizar modelos avanzados en equipos domésticos, aunque los tamaños aumentan rápidamente cuando se trabaja con modelos de mayor capacidad.
En un PC convencional, la tarjeta gráfica dispone de su propia memoria de vídeo, conocida como VRAM. Si el modelo cabe completamente en ella, el rendimiento suele ser elevado. El problema aparece cuando hay que repartirlo entre la VRAM y la memoria principal del sistema, ya que la comunicación entre ambas es más lenta.
Una Nvidia GeForce RTX 5090, por ejemplo, cuenta con 32 GB de VRAM. Esa cantidad no basta para cargar directamente modelos como Qwen3.8-Flash-Next, cuyo tamaño ronda los 90 GB. Existen técnicas para distribuir modelos grandes entre distintos tipos de memoria, pero normalmente implican una pérdida de velocidad y una configuración más compleja.
El enfoque de Apple es diferente. La CPU y la GPU del M5 Ultra utilizan memoria unificada, es decir, un mismo espacio de memoria al que pueden acceder ambos componentes. En la configuración de 256 GB, una parte muy importante de esa capacidad queda disponible para cargar modelos de IA que no cabrían en una tarjeta gráfica de consumo.
Tres cifras para medir la experiencia real
Evaluar un modelo local únicamente por el número de tokens que genera por segundo puede llevar a conclusiones equivocadas. La experiencia completa depende de varias fases, especialmente cuando se trabaja con documentos largos o agentes de programación.
- Lectura: mide la velocidad con la que el sistema procesa las instrucciones, el historial y los documentos incluidos en la consulta.
- Primer token: indica cuánto tiempo transcurre desde el envío de la petición hasta que aparece la primera parte de la respuesta. Es una referencia directa de la sensación de rapidez.
- Escritura: refleja la velocidad a la que el modelo genera el resto de la respuesta, normalmente expresada en tokens por segundo.
Esta distinción resulta especialmente importante en programación asistida por IA. Un agente puede producir código a gran velocidad, pero tardar demasiado en analizar un proyecto completo antes de empezar. Del mismo modo, un modelo que responde lentamente puede seguir siendo útil si trabaja con grandes cantidades de contexto sin necesidad de dividir la información.
Un banco de pruebas centrado en modelos locales
Para intentar encontrar los límites del Mac Studio M5 Ultra se han utilizado siete modelos y siete motores de inferencia, además de sesiones prolongadas de hasta ocho horas. Las pruebas también incluyen tareas reales de programación con agentes y mediciones del consumo eléctrico mediante un vatímetro conectado al enchufe.
El propósito no es demostrar que el ordenador sea la opción más rápida en todos los escenarios. Su ventaja está en otra parte: puede ejecutar modelos enormes sin recurrir a una infraestructura profesional ni dividirlos necesariamente entre varias tarjetas gráficas.
La memoria unificada no convierte al Mac Studio en una máquina mágica. La memoria de una GPU dedicada suele ofrecer más ancho de banda y, en modelos que caben por completo en la VRAM, una tarjeta gráfica de alta gama puede resultar más rápida. La propuesta de Apple consiste en ofrecer una capacidad extraordinaria en un único equipo, con una configuración relativamente sencilla.
¿Para quién tiene sentido?
El Mac Studio M5 Ultra de 256 GB está dirigido a investigadores, desarrolladores y empresas que necesitan ejecutar modelos locales de gran tamaño, trabajar con contextos extensos o mantener los datos dentro de sus propias instalaciones. También puede ser útil para quienes desarrollan agentes de programación y quieren probar modelos sin pagar continuamente por servicios en la nube.
Para un usuario doméstico, incluso para muchos profesionales, el precio resulta difícil de justificar. Una configuración inferior o un PC con tarjeta gráfica dedicada puede ofrecer una relación entre coste y rendimiento más equilibrada si los modelos utilizados caben en su memoria.
La conclusión preliminar es clara: el valor de este Mac Studio no está únicamente en la velocidad, sino en el volumen de IA que puede cargar y mantener en memoria. Es una máquina casi sin límites prácticos para determinados modelos locales, pero solo tiene sentido cuando esa capacidad se utiliza de forma habitual y el coste de depender de la nube, de varios equipos o de una infraestructura externa supera con claridad la inversión inicial.