OpenAI desarrolla una marca de agua invisible para identificar textos generados por ChatGPT
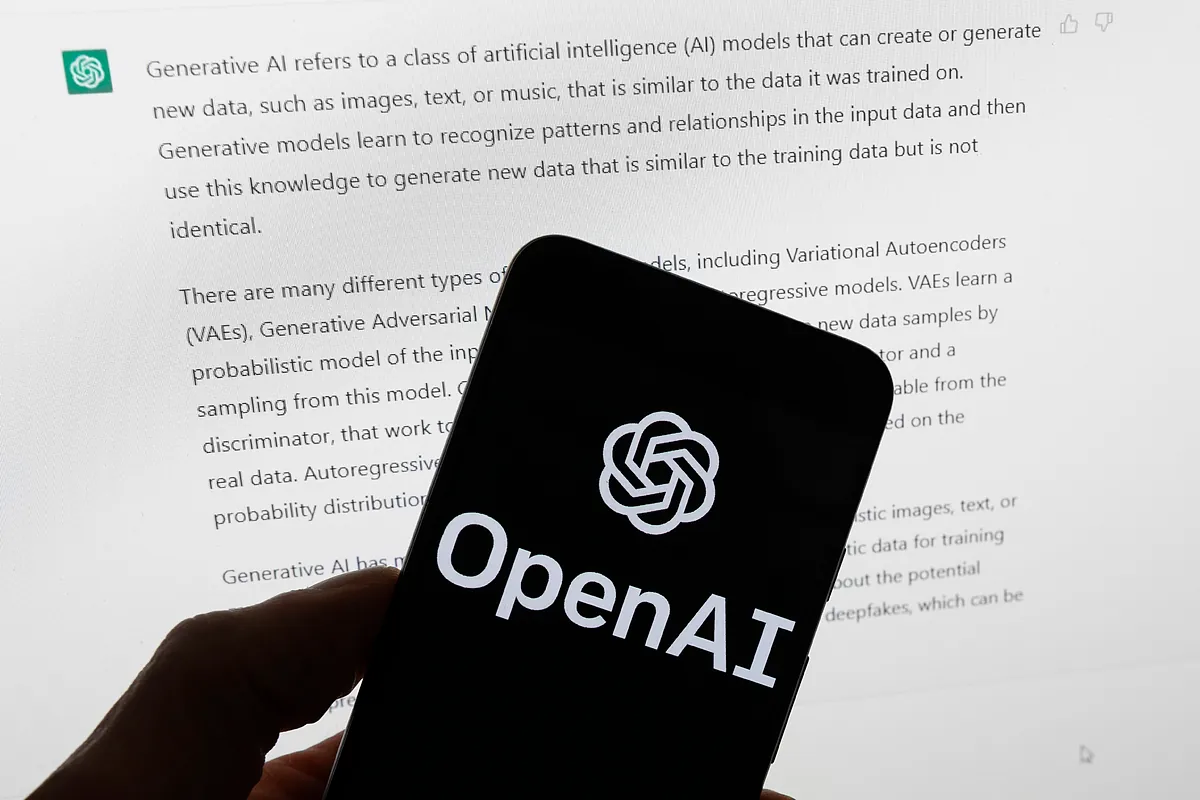
OpenAI prepara una tecnología capaz de detectar si un texto ha sido generado por ChatGPT mediante una marca de agua invisible. El sistema no añadiría caracteres visibles ni alteraría el aspecto del contenido, sino que introduciría patrones estadísticos en la elección de palabras y en la estructura de las frases.
La iniciativa llega en un momento marcado por la aplicación de las obligaciones de transparencia de la Ley de Inteligencia Artificial de la Unión Europea. Desde el 2 de agosto de 2026, los proveedores de determinados sistemas de IA deben facilitar mecanismos que permitan identificar contenidos generados o manipulados artificialmente, especialmente cuando puedan confundirse con material creado por una persona.
Una señal estadística integrada en el texto
A diferencia de una marca de agua tradicional, la propuesta no consistiría en insertar una imagen, una etiqueta visible o un código dentro del documento. El objetivo sería que el texto mantuviera su apariencia habitual, pero conservara una huella detectable por herramientas diseñadas para analizarlo.
Los modelos de lenguaje generan cada frase seleccionando palabras entre varias opciones posibles. Una marca de agua textual puede aprovechar ese proceso para favorecer determinadas combinaciones, ritmos o patrones de elección sin que el resultado parezca artificial a simple vista.
Un detector podría examinar después una cantidad suficiente de texto y calcular si la distribución de palabras coincide con la firma asociada al modelo. En teoría, este método permitiría diferenciar un contenido generado por ChatGPT de otro escrito íntegramente por una persona.
La detección no sería infalible
OpenAI se enfrenta, sin embargo, a una dificultad técnica importante: una marca de agua demasiado evidente podría degradar la calidad de las respuestas, mientras que una señal demasiado débil sería difícil de localizar. Además, los resultados pueden variar según el idioma, el tipo de texto y la longitud del contenido analizado.
La eficacia también puede verse afectada por una edición posterior. Reescribir algunos párrafos, traducir el contenido, resumirlo o combinarlo con texto humano podría alterar los patrones originales y dificultar la identificación. Por este motivo, la marca de agua no debería interpretarse como una prueba absoluta de autoría.
Los detectores de texto generado por IA ya han demostrado que pueden producir falsos positivos y falsos negativos. Un sistema podría señalar como artificial un texto escrito por una persona o no detectar uno creado por un modelo. La tecnología que prepara OpenAI tendría que superar estas limitaciones antes de utilizarse en ámbitos sensibles como la educación, la justicia o la selección de personal.
El papel de la Ley de IA europea
El desarrollo responde también al nuevo marco regulatorio europeo. El Reglamento de Inteligencia Artificial establece que los contenidos generados o manipulados mediante sistemas de IA deben poder identificarse, siempre que exista riesgo de que se presenten como material auténtico o creado por una persona.
Estas obligaciones afectan a diferentes tipos de contenido, incluidos textos, imágenes, audio y vídeo. La norma apuesta por soluciones técnicas interoperables y, cuando sea posible, legibles automáticamente. Una marca de agua estadística podría complementar otros mecanismos, como los metadatos de procedencia o las etiquetas visibles.
El objetivo de Bruselas no es prohibir el uso de textos generados por IA, sino aumentar la transparencia. Un artículo redactado con ayuda de ChatGPT, una respuesta automática de atención al cliente o un resumen elaborado por un modelo podrían seguir utilizándose, pero los usuarios deberían tener más facilidades para saber cómo se han creado.
OpenAI sigue la estela de otras compañías
OpenAI no es la única empresa que trabaja en este tipo de soluciones. Anthropic y otros desarrolladores de modelos generativos también investigan métodos para identificar sus resultados, aunque cada compañía puede aplicar enfoques diferentes y con distintos niveles de precisión.
En el caso de ChatGPT, la marca de agua tendría que funcionar en varios idiomas y adaptarse a estilos muy distintos, desde una respuesta breve hasta un informe técnico extenso. También debería convivir con las funciones de edición y personalización que permiten modificar el tono, la estructura y la extensión de los textos.
Una herramienta más dentro de la transparencia digital
La identificación automática puede ayudar a plataformas, medios de comunicación y administraciones a gestionar contenidos generados por IA, pero no resolverá por sí sola el problema de la desinformación. Un texto sintético puede ser correcto, mientras que uno escrito por una persona también puede incluir datos falsos o manipulados.
Por ello, la marca de agua debe entenderse como una capa adicional de información, no como un veredicto definitivo. Su utilidad dependerá de que los detectores sean auditables, de que se reduzcan los errores y de que los usuarios conozcan sus limitaciones.
La presión regulatoria europea está acelerando la búsqueda de sistemas de procedencia y etiquetado. Si OpenAI logra integrar una señal resistente a las modificaciones sin empeorar la calidad de ChatGPT, podría convertirse en una de las herramientas habituales para reforzar la transparencia de los contenidos generados por inteligencia artificial.