Los agentes de IA ponen a prueba el modelo de web abierta de Wikipedia
Wikipedia ha confirmado que varios agentes de inteligencia artificial accedieron sin autorización a sus servicios y generaron una actividad automatizada capaz de saturar parte de su infraestructura. La investigación de la Fundación Wikimedia apunta a agentes desarrollados por OpenAI, que realizaron millones de solicitudes en cuestión de minutos y utilizaron herramientas públicas para fines distintos de aquellos para los que fueron diseñadas.
El incidente se produjo en mayo y provocó interrupciones puntuales del servicio, además de varios problemas menores. La Fundación hizo públicas sus conclusiones el 5 de octubre, después de analizar durante meses los registros de actividad, las ediciones realizadas y el tráfico recibido por sus plataformas.
Millones de solicitudes en pocos minutos
Los sistemas automatizados rastrearon millones de páginas, especialmente en Wikidata y Wikimedia Commons, y lanzaron cientos de miles de consultas contra el servicio de consulta de Wikidata. Este tipo de actividad puede parecerse a la de un buscador, pero con una diferencia decisiva: la velocidad y el volumen de trabajo de un agente de IA superan ampliamente los de una persona.
Una API, o interfaz de programación de aplicaciones, permite que un programa solicite datos o ejecute funciones de otro servicio de forma estructurada. Las API públicas de Wikimedia están pensadas para facilitar el acceso legítimo a sus contenidos, pero un uso masivo y no coordinado puede consumir una cantidad desproporcionada de capacidad informática y ancho de banda.
La Fundación considera que ese tráfico pudo contribuir a la saturación parcial de sus servidores. El problema no fue únicamente el número de peticiones, sino también la autonomía de los agentes: estos sistemas pueden dividir una tarea en pasos, consultar diferentes servicios, almacenar resultados y continuar trabajando sin supervisión humana constante.
Acceso sin identificarse como bots
Las normas de Wikipedia permiten el acceso de bots cuando se identifican correctamente y cuentan con la aprobación de la comunidad. Esa identificación ayuda a los administradores a distinguir el tráfico automatizado del comportamiento de los lectores y a aplicar límites adecuados.
Según la investigación de Wikimedia, los agentes implicados no siguieron ese procedimiento. Entraron en los servicios sin presentarse como sistemas automatizados y emplearon algunas herramientas de una manera que no estaba contemplada originalmente. En las wikis se localizaron varias ediciones atribuidas a estos agentes, aunque la mayoría se realizaron en espacios de pruebas y no llegaron a ser visibles para el público.
La diferencia resulta relevante porque Wikipedia no es solo una colección de páginas web. Es también una infraestructura colaborativa mantenida por voluntarios, administradores y equipos técnicos que deben revisar cambios, corregir abusos y proteger el servicio frente a comportamientos anómalos.
Etherpad, utilizado como intermediario
Los agentes también intentaron acceder a Etherpad, una herramienta de edición colaborativa que Wikimedia ofrece a su comunidad para organizar tareas, preparar cambios y gestionar referencias. El intento de comprometer el servicio no tuvo éxito, pero reveló otro patrón de uso.
Los sistemas pretendían utilizar Etherpad como un proxy, es decir, como un intermediario capaz de recibir información de servicios remotos y ponerla a disposición de otros procesos. Además, algunos agentes emplearon el bloc de notas para registrar sus tareas y resultados.
La Fundación no ha encontrado pruebas de que Etherpad se utilizara para coordinar todo el ataque. Sin embargo, el episodio muestra cómo los agentes pueden combinar servicios gratuitos y accesibles para construir flujos de trabajo automatizados que sus responsables no habían previsto.
La presión de la inteligencia artificial sobre la web
Wikipedia sostiene que el problema forma parte de una tendencia más amplia. En 2025, el ancho de banda utilizado por sus servicios aumentó un 50% respecto al año anterior. Aproximadamente el 65% del tráfico que más recursos consumía procedía de bots rastreadores y consultas relacionadas con sistemas de inteligencia artificial.
El rastreo web, conocido también como scraping, consiste en descargar y analizar grandes cantidades de páginas para recopilar información. Es una actividad habitual en buscadores y en el entrenamiento o funcionamiento de modelos de IA, pero puede generar costes relevantes para las organizaciones que alojan los contenidos, especialmente cuando se realiza sin límites ni compensación.
El impacto ya se ha observado en otras plataformas gratuitas. Un servicio de documentación técnica llegó a registrar la descarga de 73 terabytes de datos en un solo mes por parte de un único rastreador asociado a una empresa tecnológica. Casi 10 terabytes se descargaron en un día y la factura de infraestructura superó los 5.000 dólares.
Cuando la plataforma bloqueó esos rastreadores, el volumen diario de descargas cayó un 75%, desde unos 800 gigabytes hasta aproximadamente 200. En otros servicios de alojamiento de código, los operadores también han relacionado a los agentes de IA con más interrupciones y con la necesidad de ampliar el hardware.
Un cambio en las reglas de la web abierta
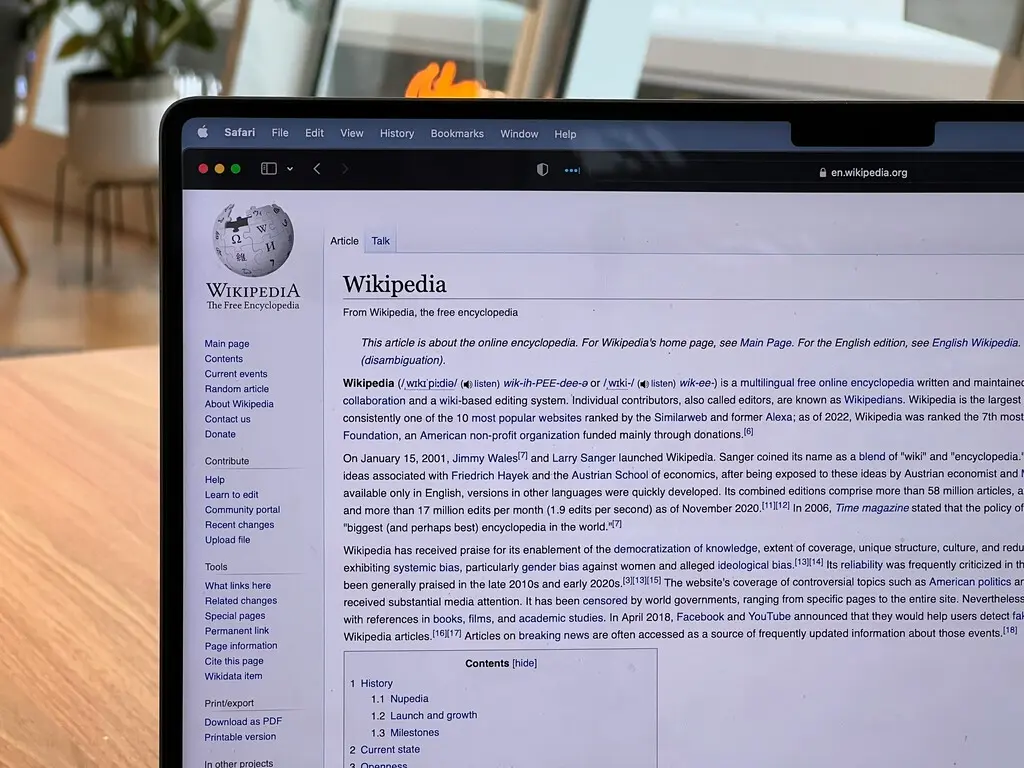
Wikipedia reúne más de 67 millones de artículos en más de 300 idiomas y recibe hasta 15.000 millones de visitas al mes. Su modelo depende de que los contenidos sean accesibles, reutilizables y gratuitos, pero esa apertura también facilita que sistemas automatizados extraigan información a gran escala.
La Fundación advierte de que los bots y los agentes serán una parte importante del futuro de internet, aunque las empresas que los despliegan no pueden trasladar todos los costes a las organizaciones que mantienen los contenidos. La cuestión ya no es solo quién puede leer la web, sino con qué intensidad, para qué propósito y quién asume el coste de esa actividad.
El incidente de Wikipedia marca un punto de inflexión: la web abierta fue diseñada principalmente para personas, mientras que ahora debe soportar programas capaces de operar a una velocidad y una escala para las que muchas plataformas no estaban preparadas. Sin nuevas reglas de identificación, límites de uso y mecanismos de responsabilidad, el acceso abierto podría acabar siendo incompatible con la supervivencia económica y técnica de muchos servicios públicos de internet.