La nueva prueba para la inteligencia artificial consiste en detectar si has montado bien un mueble de IKEA
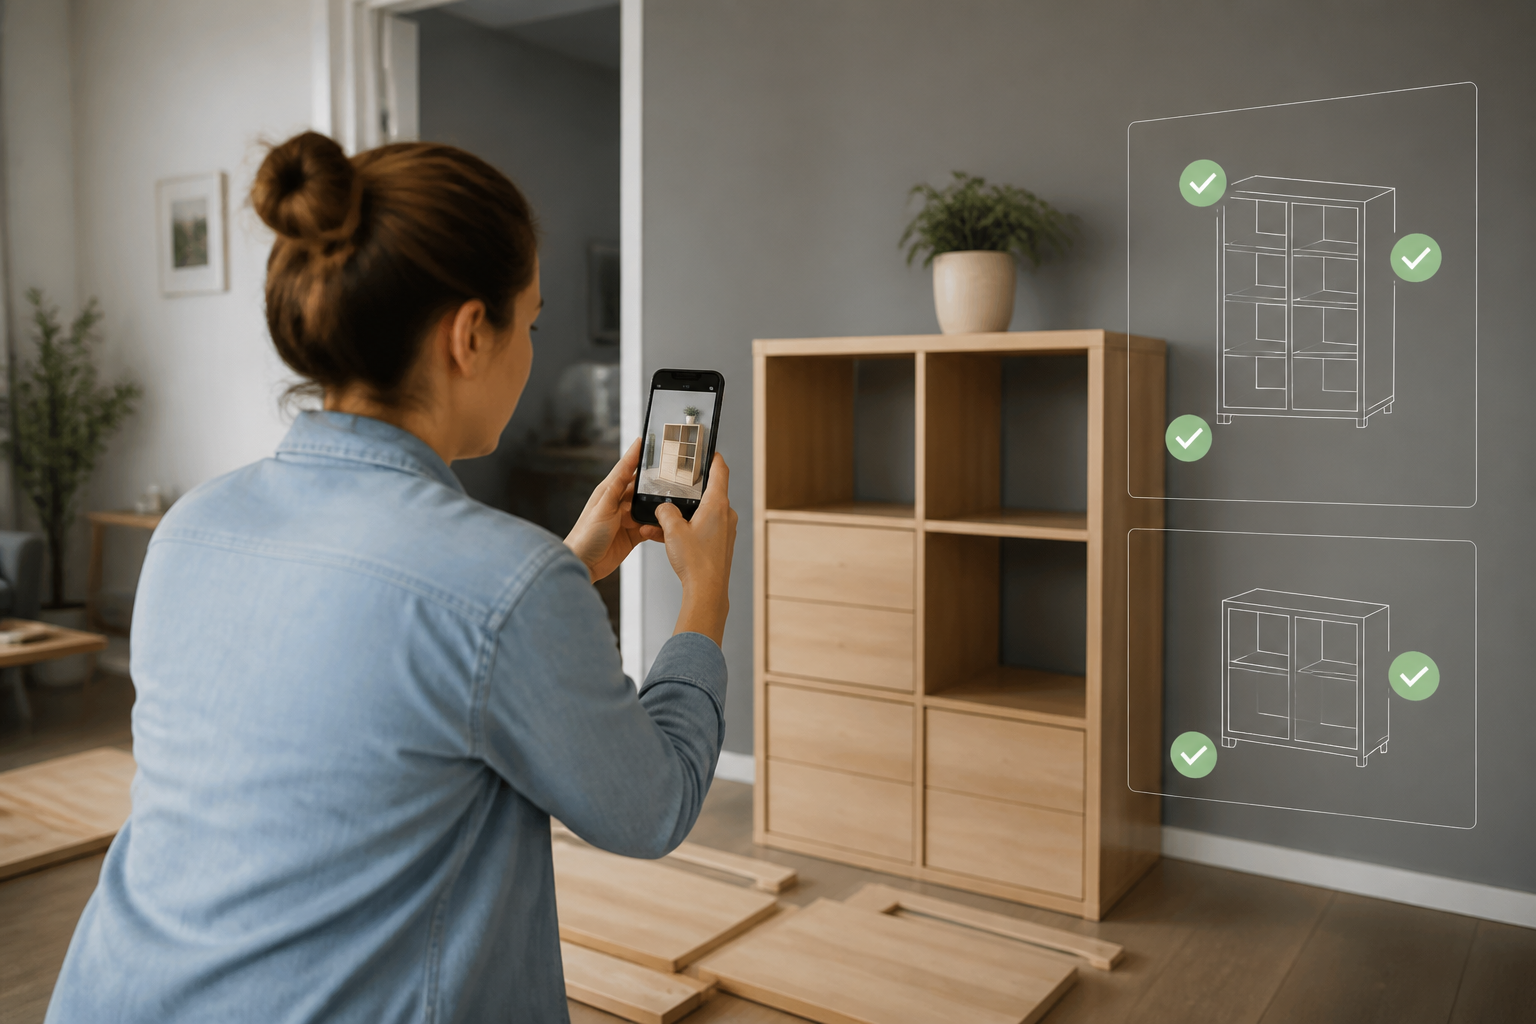
La inteligencia artificial ya no solo se examina con problemas matemáticos, código o preguntas de cultura general. Un nuevo banco de pruebas plantea un reto mucho más cotidiano: mostrar a un modelo una fotografía de un mueble de IKEA a medio montar y pedirle que determine si el ensamblaje es correcto.
La tarea no termina ahí. Si existe un error, el sistema debe localizarlo y explicar qué pieza se ha colocado mal, en qué orientación o en qué paso del manual se produjo el fallo. Los resultados más recientes muestran una mejora notable: el mejor modelo ha pasado de acertar el 28% de los casos al 80% en apenas diez meses.
Del 28% al 80% de aciertos
La prueba se conoce como Furniture Assembly Benchmark (FAB), un benchmark o evaluación estandarizada diseñada para comparar las capacidades de distintos modelos de inteligencia artificial en una misma tarea.
En noviembre de 2025, el sistema con mejores resultados era Claude 4,5, con un 28% de respuestas correctas. En septiembre de 2026, GPT-6 Astra ha alcanzado el 80%. Además, ha necesitado una media de tres minutos para analizar cada imagen, entre dos y diez veces menos tiempo que algunos de los modelos que anteriormente destacaban en esta evaluación.
La evolución resulta especialmente llamativa porque el reto no consiste en reconocer un objeto conocido. La IA debe comprobar si ese objeto se ha construido siguiendo unas instrucciones concretas y detectar desviaciones que pueden quedar parcialmente ocultas.
Una fotografía, un manual y mucho razonamiento
Para resolver cada caso, los modelos reciben una imagen de un mueble a medio montar, el manual oficial de instrucciones, una herramienta para ampliar distintas zonas de la fotografía y un intérprete de Python, un entorno que permite ejecutar código para realizar cálculos o analizar datos.
Con esa información, el sistema tiene que relacionar los diagramas del manual con las piezas que aparecen en la imagen. También debe deducir qué pasos se han completado, reconstruir en qué orden se ha realizado el montaje y comprobar si algún componente está invertido, desplazado o instalado en una fase incorrecta.
El diseño de la prueba añade dificultad de forma deliberada. Los responsables del experimento compraron tres muebles y cometieron errores a propósito durante el montaje. Después continuaron ensamblando otras piezas, de modo que el fallo no siempre era el último elemento visible en la fotografía. Así se evita que la IA se limite a revisar únicamente la parte más reciente del proceso.
Un examen de razonamiento espacial
Aunque IKEA es el escenario, los muebles son solo una herramienta para evaluar una capacidad más amplia: el razonamiento abstracto aplicado al mundo físico. En este contexto, un modelo debe conectar instrucciones generales, normalmente representadas mediante dibujos, con objetos reales vistos desde un ángulo determinado.
Esta habilidad puede resultar esencial para futuras aplicaciones. Un asistente de IA podría ayudar a reparar un electrodoméstico, interpretar la documentación técnica de un vehículo o verificar si una instalación se ha realizado correctamente. En todos esos casos no basta con identificar piezas: hay que comprender la relación entre las instrucciones y su disposición en el entorno.
Las pruebas de matemáticas y programación son relativamente fáciles de corregir porque suelen tener una solución verificable. En cambio, evaluar la visión artificial y la comprensión espacial es más complejo. Una imagen puede ocultar información, ofrecer perspectivas ambiguas o mostrar varias configuraciones aparentemente válidas.
El problema de buscar errores que no existen
La evaluación también ha puesto de manifiesto que los modelos pueden equivocarse en direcciones opuestas. Algunos sistemas de las familias Gemini y Qwen tendían a asumir que siempre había un fallo y señalaban errores inexistentes. Este comportamiento se conoce como falso positivo: el modelo detecta un problema cuando el montaje es correcto.
Otros modelos anteriores de OpenAI y Anthropic mostraban el sesgo contrario. Daban por válido un mueble que en realidad contenía una pieza mal colocada. En este caso se produce un falso negativo, porque el sistema no identifica un error real.
La diferencia es importante. Una herramienta que acusa constantemente de fallos puede resultar tan poco útil como otra que aprueba cualquier resultado. Un asistente fiable debe saber cuándo seguir buscando problemas y cuándo concluir que el trabajo está bien hecho.
Un paso hacia robots más útiles, pero no autónomos
El FAB no demuestra que una máquina pueda montar un mueble por sí sola. La prueba analiza un trabajo realizado por una persona y pide a la IA que lo verifique a partir de una imagen y un manual. No evalúa la capacidad de sujetar piezas, utilizar herramientas, corregir imprevistos o ejecutar físicamente cada paso.
Reconocer que una tabla está colocada al revés es muy distinto a manipularla, identificar la orientación correcta y fijarla sin ayuda. Por eso, los resultados no implican que los robots domésticos estén preparados para montar muebles, aunque sí muestran avances en una de las capacidades que necesitarían para hacerlo.
El experimento recupera así la llamada paradoja de Moravec. Esta idea sostiene que las máquinas pueden rendir muy bien en tareas que consideramos intelectualmente difíciles, como resolver cálculos, pero encuentran grandes obstáculos en acciones que los humanos realizamos casi sin pensar, como interpretar una escena o coordinar movimientos en el espacio.
Los benchmarks empiezan a medir mejor ese terreno intermedio entre el razonamiento digital y la realidad física. Y, por ahora, una de las formas más eficaces de comprobarlo es preguntar a una IA si hemos montado correctamente el mueble del salón.