Un modelo de IA logra que casi la mitad de los participantes crea que habla con una persona por videollamada
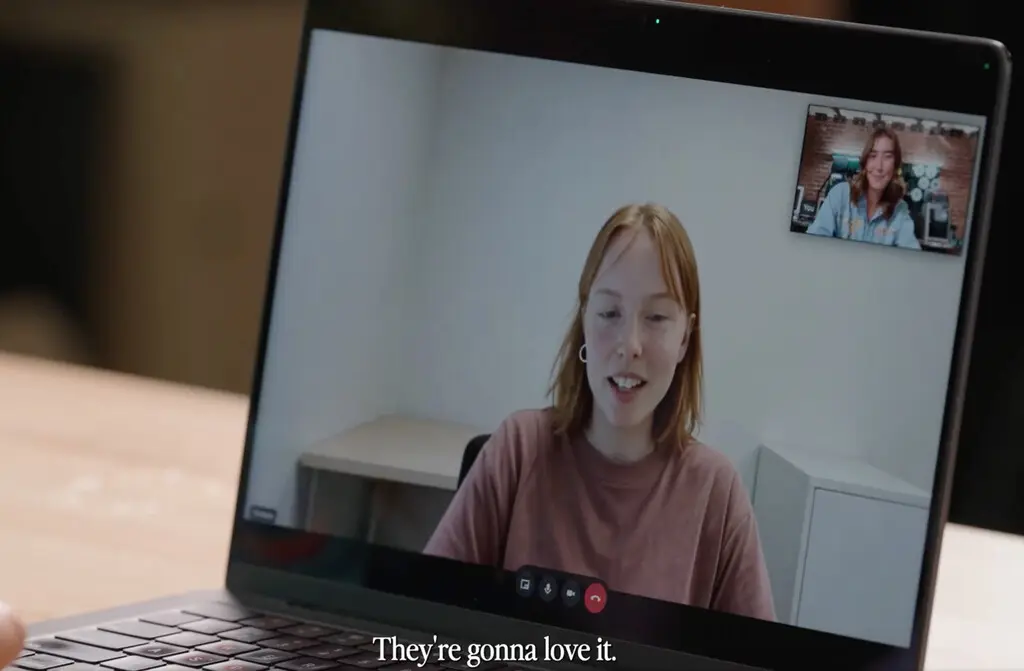
Griffin-Lite, un sistema desarrollado por Tavus, ha conseguido que 26 de 54 participantes identificaran como humana una conversación audiovisual generada íntegramente por inteligencia artificial. El experimento, realizado en tiempo real, pone el foco en una de las fronteras más complejas de la IA: mantener una interacción por vídeo con respuestas, interrupciones, gestos y miradas que parezcan naturales.
La compañía sostiene que el resultado equivale a superar por primera vez un test de Turing en vídeo. Sin embargo, la afirmación necesita matices. No existe un protocolo universal para esta variante de la prueba y el ensayo fue reducido, con una muestra de 54 personas y una conversación de solo un minuto.
Una conversación breve sobre las expectativas del año
Los participantes creían que iban a conversar con otra persona sobre aquello que esperaban con ilusión durante el año. En realidad, al otro lado de la videollamada estaba Griffin-Lite, una versión preliminar del modelo que generaba tanto las respuestas como la presencia visual de la interlocutora.
La pregunta sobre si habían hablado con un ser humano no se planteó al principio. Antes, los participantes evaluaron la naturalidad, la confianza y la fluidez de la conversación. Al terminar, 26 de ellos, el 48%, afirmaron que habían creído estar hablando con una persona real.
La diferencia frente al sistema anterior de la compañía fue notable. En una prueba equivalente, solo una persona de 41 consideró humana a la interlocutora artificial. Aun así, el experimento fue diseñado y analizado por la propia empresa, aunque el reclutamiento de los participantes se realizó mediante una plataforma independiente.
Qué es y qué no es un test de Turing en vídeo
El test de Turing fue planteado por el matemático británico Alan Turing en 1950 para explorar si una máquina podía mantener una conversación indistinguible de la de una persona. En su formulación original, la comunicación era exclusivamente escrita, con el objetivo de eliminar pistas relacionadas con el aspecto físico o la voz.
La prueba presentada ahora traslada esa idea a una videollamada, pero no constituye una versión estandarizada del test clásico. El concepto de test de Turing en vídeo también se ha utilizado en investigaciones anteriores con un propósito distinto, como evaluar si un sistema comprende el contenido de un vídeo de una manera comparable a un ser humano.
Por tanto, el resultado de Griffin-Lite no demuestra que el modelo posea una inteligencia humana general. Indica que, bajo unas condiciones concretas y durante un periodo limitado, puede producir una interacción audiovisual suficientemente convincente para confundir a parte de los participantes.
Un sistema que escucha mientras habla
La principal novedad técnica de Griffin-Lite es su funcionamiento full-duplex. Este término describe un sistema capaz de escuchar y generar respuestas al mismo tiempo, en lugar de esperar a que el usuario termine completamente su intervención para comenzar a procesarla.
El modelo vuelve a evaluar la conversación en intervalos inferiores a un segundo. Así puede asentir mientras la otra persona sigue hablando, interpretar una pausa, aceptar una interrupción o reaccionar ante un objeto que el usuario muestra a cámara.
En los sistemas tradicionales, la conversación suele dividirse en turnos muy definidos: el usuario habla, la inteligencia artificial procesa el audio y después responde. Griffin-Lite intenta eliminar esa separación rígida y coordina voz, rostro, mirada y gestos a partir de las mismas decisiones conversacionales.
Por debajo de la referencia humana en naturalidad
El modelo también aparece en VideoFDB, un banco de pruebas de NVIDIA creado con 237 fragmentos de videollamadas reales y 11 dinámicas conversacionales. La evaluación puntúa de 0 a 5 distintos aspectos de la percepción y la generación de las respuestas, mediante un sistema de valoración basado en otro modelo de lenguaje.
- Percepción: Griffin-Lite obtiene una puntuación de 3,73, frente al 4,20 de la referencia humana.
- Generación: alcanza 3,83, mientras que la referencia humana se sitúa en 3,92.
Las cifras muestran un avance importante, pero también reflejan que la interacción todavía no iguala completamente a la humana. Las pausas, la espontaneidad, la comprensión del contexto y la coordinación entre lenguaje y lenguaje corporal siguen siendo difíciles de reproducir con total naturalidad.
Un modelo de investigación con riesgos evidentes
Griffin-Lite no está disponible actualmente para el público general ni puede utilizarse como asistente en cualquier videollamada. La empresa lo mantiene como un modelo de investigación para un grupo seleccionado de evaluadores y ha adelantado que prepara una versión más potente.
Tavus sí comercializa agentes audiovisuales, conocidos como PALs, que pueden integrarse en aplicaciones mediante interfaces de programación, crearse sin código o desarrollarse para empresas. Sus posibles usos incluyen ventas, formación y atención al cliente.
La capacidad de parecer humano plantea, sin embargo, un problema de transparencia. Una IA que responde con naturalidad, mira a cámara y acepta interrupciones puede hacer que el usuario no sepa con quién está hablando. La compañía reconoce ese riesgo y asegura que trabaja en mecanismos de aviso antes de ampliar el lanzamiento.
La empresa también exige consentimiento explícito e informado para crear réplicas digitales de la imagen o la voz de una persona, además de informar claramente cuando la interacción se produce con una inteligencia artificial. Estas medidas serán esenciales si los agentes de vídeo pasan de las demostraciones controladas a servicios utilizados a diario.
El avance de Griffin-Lite no convierte a la IA en una persona, pero sí demuestra que la frontera visual entre una videollamada humana y una conversación sintética empieza a ser mucho más difícil de detectar.