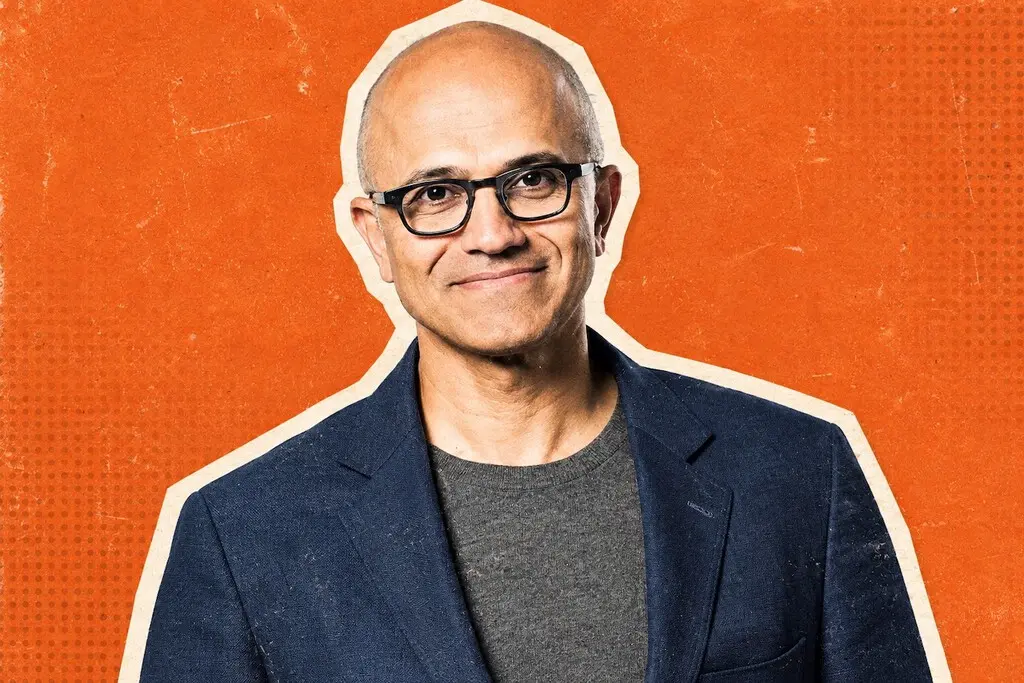
Satya Nadella pide tratar todos los modelos de IA como sistemas potencialmente comprometidos
El consejero delegado de Microsoft, Satya Nadella, ha defendido un cambio de enfoque en la seguridad de la inteligencia artificial: las empresas deberían confiar lo mínimo posible en los modelos y separar su capacidad para generar respuestas de la autoridad para actuar. En la práctica, esto implica rodear a la IA de permisos limitados, supervisión independiente, registros completos y mecanismos capaces de detenerla.
La propuesta llega en un momento en el que los agentes de inteligencia artificial empiezan a conectarse con herramientas corporativas, bases de datos y servicios capaces de ejecutar acciones en nombre de los usuarios. Estos sistemas pueden redactar informes, analizar información, modificar documentos o tomar decisiones operativas, pero su funcionamiento interno sigue siendo difícil de explicar incluso para sus desarrolladores.
La caja negra de los modelos de inteligencia artificial
En el software tradicional, un error suele poder rastrearse hasta una instrucción concreta escrita por un programador. En los modelos de IA generativa, en cambio, las respuestas se producen a partir de patrones aprendidos durante el entrenamiento. El sistema puede ofrecer un resultado correcto sin que exista una explicación sencilla y verificable de cómo ha llegado hasta él.
Esta característica se conoce como caja negra: se pueden observar las entradas y las salidas, pero no siempre se entiende con precisión qué procesos internos han conducido a una decisión. El problema aumenta cuando el modelo tiene acceso a información sensible o puede utilizar otras aplicaciones sin una revisión humana previa.
Para Nadella, las empresas no pueden trasladar su responsabilidad al proveedor del modelo. Las garantías de seguridad de una compañía tecnológica no eximen a la organización que integra la IA de controlar lo que ocurre en sus propios sistemas.
Una IA con los permisos de un empleado de alto riesgo
El enfoque defendido por el ejecutivo consiste en tratar a los modelos como si fueran empleados con una gran capacidad operativa, pero también con posibilidades de equivocarse, ser manipulados o sufrir un ataque. Por ese motivo, deberían recibir únicamente los permisos imprescindibles para realizar una tarea.
Este principio se conoce como mínimo privilegio. Significa que un sistema no debe poder acceder a toda una red, leer cualquier documento o ejecutar acciones irreversibles si solo necesita una parte de esas capacidades. Si un agente de IA necesita consultar una base de datos, por ejemplo, no debería tener automáticamente autorización para modificarla o borrar su contenido.
La estrategia también exige registrar cada acción relevante. Estos registros, conocidos como logs, permiten saber qué hizo el modelo, qué información consultó, qué herramientas utilizó y qué instrucciones recibió. Sin esa trazabilidad, investigar un incidente o atribuir responsabilidades puede resultar prácticamente imposible.
Siete principios para contener la inteligencia artificial
La propuesta de Nadella se articula en torno a siete medidas destinadas a reducir la dependencia de un único modelo y a mantener el control humano sobre los sistemas:
- Diversidad de modelos: evitar que una organización dependa de un solo proveedor o de una única arquitectura de IA.
- Observación completa: supervisar las entradas, las salidas, las herramientas utilizadas y las decisiones tomadas.
- Verificabilidad: comprobar de forma independiente si el sistema cumple las reglas y los objetivos establecidos.
- Controles independientes: separar la generación de respuestas de la autorización para ejecutar acciones.
- Auditorías externas: revisar la seguridad y el comportamiento del sistema sin depender únicamente de sus desarrolladores.
- Contención: limitar el alcance de un fallo y disponer de un mecanismo de parada inmediata.
- Divulgación de incidentes: comunicar los problemas relevantes para evitar que se repitan en otras organizaciones.
Estos principios pueden resumirse en una idea: la inteligencia no debe equivaler automáticamente a autoridad. Un modelo puede proponer una respuesta, clasificar información o recomendar una acción, pero la decisión de ejecutarla debería depender de controles externos y claramente definidos.
Un freno de emergencia para los agentes de IA
La contención ocupa un lugar central en este planteamiento. Un sistema contenido opera dentro de unos límites técnicos que reducen el impacto de un error. Esos límites pueden incluir entornos aislados, permisos temporales, aprobación humana para operaciones críticas y barreras que impidan acceder a determinados datos o servicios.
También sería necesario contar con un interruptor de emergencia capaz de detener al agente sin depender de sus propias instrucciones. La medida resulta especialmente importante en sistemas autónomos, ya que un modelo podría interpretar de manera incorrecta una orden, seguir una estrategia no prevista o ser manipulado mediante instrucciones maliciosas.
La seguridad conocida como defensa en profundidad aplica varias capas de protección. Si falla el modelo, debe responder el sistema de permisos; si falla ese control, debe actuar la monitorización; y si el comportamiento sigue siendo anómalo, la organización debe poder aislar o apagar el servicio.
La posición de Microsoft y sus contradicciones
La postura de Nadella encaja con la posición de Microsoft en el mercado. La compañía desarrolla sus propios modelos, ofrece infraestructura en la nube mediante Azure y aloja tecnologías de terceros. Un ecosistema con varios modelos y proveedores puede reducir la dependencia de una única empresa, pero también incrementa la necesidad de disponer de normas comunes para desplegarlos con seguridad.
Al mismo tiempo, el planteamiento presenta una tensión evidente. Microsoft ha defendido en distintos momentos un desarrollo responsable de la IA, mientras continúa ampliando su infraestructura de centros de datos, esencial para entrenar y ejecutar modelos cada vez más grandes. Estas instalaciones requieren enormes cantidades de energía, capacidad de procesamiento y recursos económicos.
La idea de fondo no es que los modelos sean necesariamente maliciosos. El riesgo procede de combinar sistemas difíciles de interpretar con permisos amplios y acceso a infraestructuras importantes. Por eso, la seguridad no debería depender solo de que el modelo se comporte bien, sino de que el entorno pueda observarlo, limitarlo y detenerlo en cualquier momento.
El mensaje de Nadella apunta así a un posible estándar tecnológico para la próxima generación de agentes de IA: modelos útiles, pero contenidos; capaces de aportar conocimiento, aunque sin recibir por defecto la autoridad para actuar sin supervisión.