El MIT identifica en seis modelos de IA una organización modular parecida a la del cerebro humano
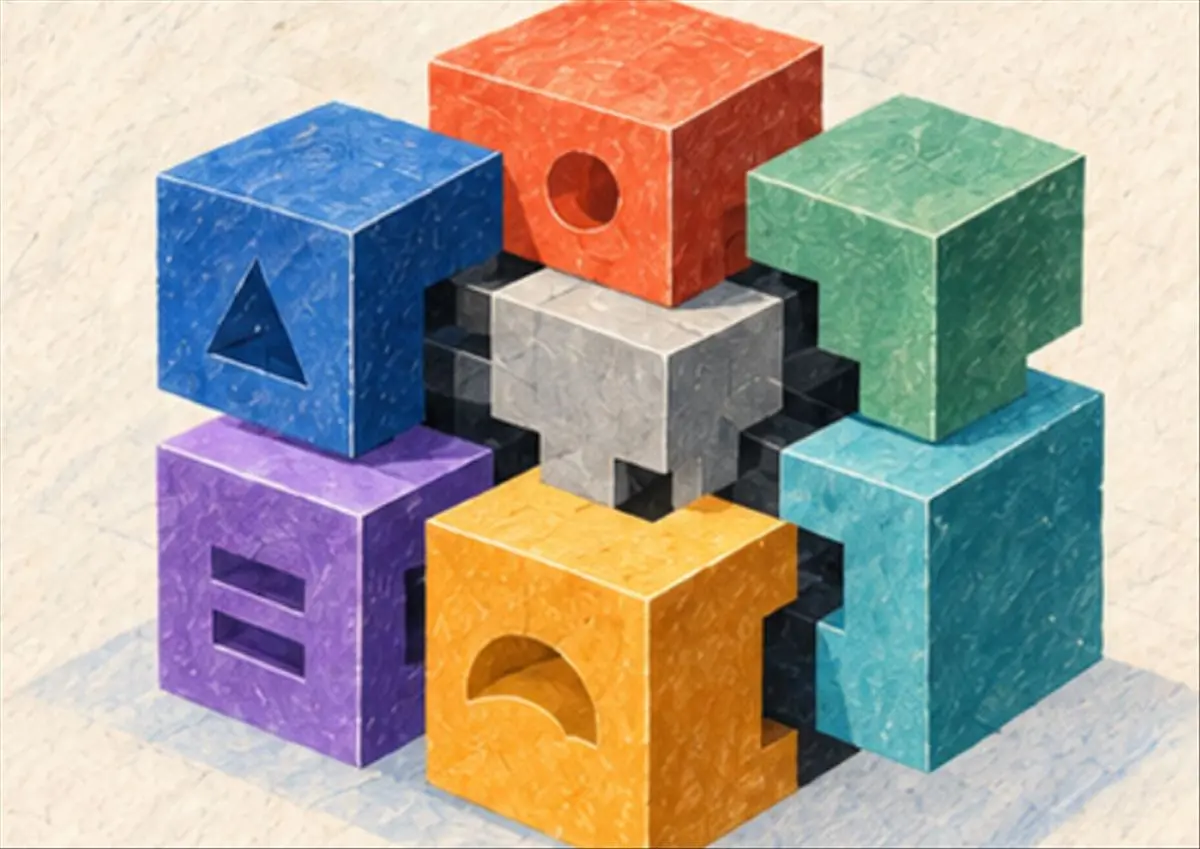
Un equipo del MIT ha detectado en seis grandes modelos de lenguaje una organización interna formada por cuatro dominios cognitivos que recuerda a la descrita por la neurociencia en el cerebro humano. El hallazgo apunta a que determinadas capacidades, como comprender el lenguaje o resolver problemas físicos, podrían apoyarse en grupos de neuronas artificiales parcialmente diferenciados.
El estudio, firmado por Pengrui Han, Jacob Andreas, Evelina Fedorenko y Andrea Gregor de Varda, analiza si los modelos de inteligencia artificial desarrollan representaciones internas especializadas aunque no hayan sido diseñados con módulos cognitivos explícitos. Sus resultados se recogen en el trabajo identificado como arXiv:2608.13567.
Cuatro dominios para estudiar la inteligencia artificial
La investigación comparó el comportamiento interno de los modelos en 46 tareas cognitivas agrupadas en cuatro áreas: lenguaje, razonamiento formal, razonamiento físico y razonamiento social. La clasificación sigue una división utilizada en estudios sobre los sistemas cognitivos del córtex humano.
- Lenguaje: comprensión y producción de información lingüística.
- Razonamiento formal: resolución de problemas lógicos, matemáticos o basados en reglas.
- Razonamiento físico: interpretación de propiedades, objetos y acontecimientos del mundo físico.
- Razonamiento social: comprensión de intenciones, estados mentales y relaciones entre personas.
La hipótesis de partida era que, si los modelos de lenguaje desarrollan representaciones parecidas a las que emplea el cerebro, las tareas pertenecientes al mismo dominio deberían activar grupos de neuronas artificiales con un alto grado de solapamiento. En cambio, las tareas asociadas a capacidades distintas deberían recurrir a conjuntos de parámetros más diferenciados.
Seis modelos analizados y un modelo de control
El patrón apareció en seis modelos de lenguaje de diferentes tamaños y familias. El análisis incluyó Mistral-Small-24B, con unos 24.000 millones de parámetros, y Mistral-Large-123B, con aproximadamente 123.000 millones.
También se estudiaron Qwen2.5-32B, OLMo-2-32B, Llama-3.1-70B y Qwen2.5-72B. Como referencia adicional, los investigadores utilizaron GPT-2-small, un modelo anterior y de menor tamaño, para comprobar cómo se comportaba el análisis en una arquitectura más limitada.
La conclusión principal es que los seis modelos modernos muestran una organización interna compatible con cuatro módulos funcionales. Esto no significa que posean regiones cerebrales equivalentes ni que comprendan el mundo como lo hace una persona. La similitud se refiere a la forma en la que distribuyen y utilizan parte de sus representaciones internas.
De la correlación a la comprobación causal
Uno de los aspectos más relevantes del trabajo es la metodología empleada. Los investigadores no se limitaron a observar qué neuronas artificiales se activaban durante cada tarea, sino que intentaron comprobar si esas unidades eran necesarias para el comportamiento del modelo.
Tres herramientas para interpretar los modelos
El primer procedimiento fue el attribution patching, una técnica que permite estimar qué parámetros o activaciones influyen en una respuesta concreta. De este modo, el equipo pudo localizar las partes de la red más relacionadas con cada tarea.
Después aplicó el índice de Jaccard, una medida estadística que cuantifica cuánto se solapan dos conjuntos. En este caso, sirvió para comparar los grupos de neuronas artificiales activados por tareas distintas y determinar si las tareas del mismo dominio recurrían a componentes comunes.
La tercera fase consistió en una ablación causal por activación. Los científicos desactivaron grupos específicos de neuronas artificiales y observaron las consecuencias. Al afectar de forma selectiva a las tareas de un dominio, sin perjudicar en la misma medida a los demás, obtuvieron indicios de que la modularidad no era solo una correlación estadística.
Esta comprobación es importante para la IA interpretable, el campo que trata de entender cómo toman decisiones los modelos. Detectar un patrón no demuestra que ese patrón sea funcionalmente necesario. En cambio, alterar una parte concreta de la red y observar un efecto específico ofrece una evidencia causal más sólida.
Una arquitectura emergente, no programada
Ninguno de los modelos analizados fue entrenado con instrucciones que asignaran determinados parámetros al lenguaje, al razonamiento físico o a la comprensión social. La separación entre capacidades habría surgido durante el proceso de optimización, al aprender a predecir y generar información a partir de grandes cantidades de datos.
Este resultado plantea una posibilidad relevante: la modularidad cognitiva podría ser una solución eficiente para procesar información compleja. Tanto el cerebro humano como una red neuronal artificial necesitan reutilizar conocimientos, especializar recursos y evitar que cada tarea interfiera constantemente con las demás.
La investigación también puede tener consecuencias prácticas. Si los módulos relacionados con el lenguaje y el razonamiento físico son parcialmente independientes, identificar cuál de ellos falla podría facilitar la corrección de errores. En sistemas multimodales, por ejemplo, este enfoque ayudaría a estudiar por separado las alucinaciones lingüísticas y los fallos al interpretar imágenes o relaciones físicas.
Una semejanza que debe interpretarse con cautela
El estudio no demuestra que los modelos de lenguaje funcionen como cerebros ni que tengan conciencia, emociones o comprensión humana. Los modelos generan respuestas mediante redes matemáticas entrenadas con datos, mientras que el cerebro es un sistema biológico con mecanismos, objetivos y formas de aprendizaje muy diferentes.
Lo que sí aporta el trabajo es una comparación experimental entre dos tipos de sistemas de procesamiento de información. La presencia de módulos funcionales en modelos que no fueron diseñados expresamente para tenerlos sugiere que ciertas estructuras pueden emerger cuando una red debe resolver tareas variadas con recursos limitados.
Para el futuro, esta línea de investigación podría impulsar modelos con separaciones internas más controladas, herramientas de diagnóstico más precisas y sistemas capaces de contener determinados fallos sin comprometer todas sus capacidades. La cuestión ya no es solo qué responde una inteligencia artificial, sino qué partes de su arquitectura hacen posible cada respuesta.