OpenAI diseña su primer chip de IA, Jalapeño, en menos de 20 meses y estrecha el cerco sobre Nvidia
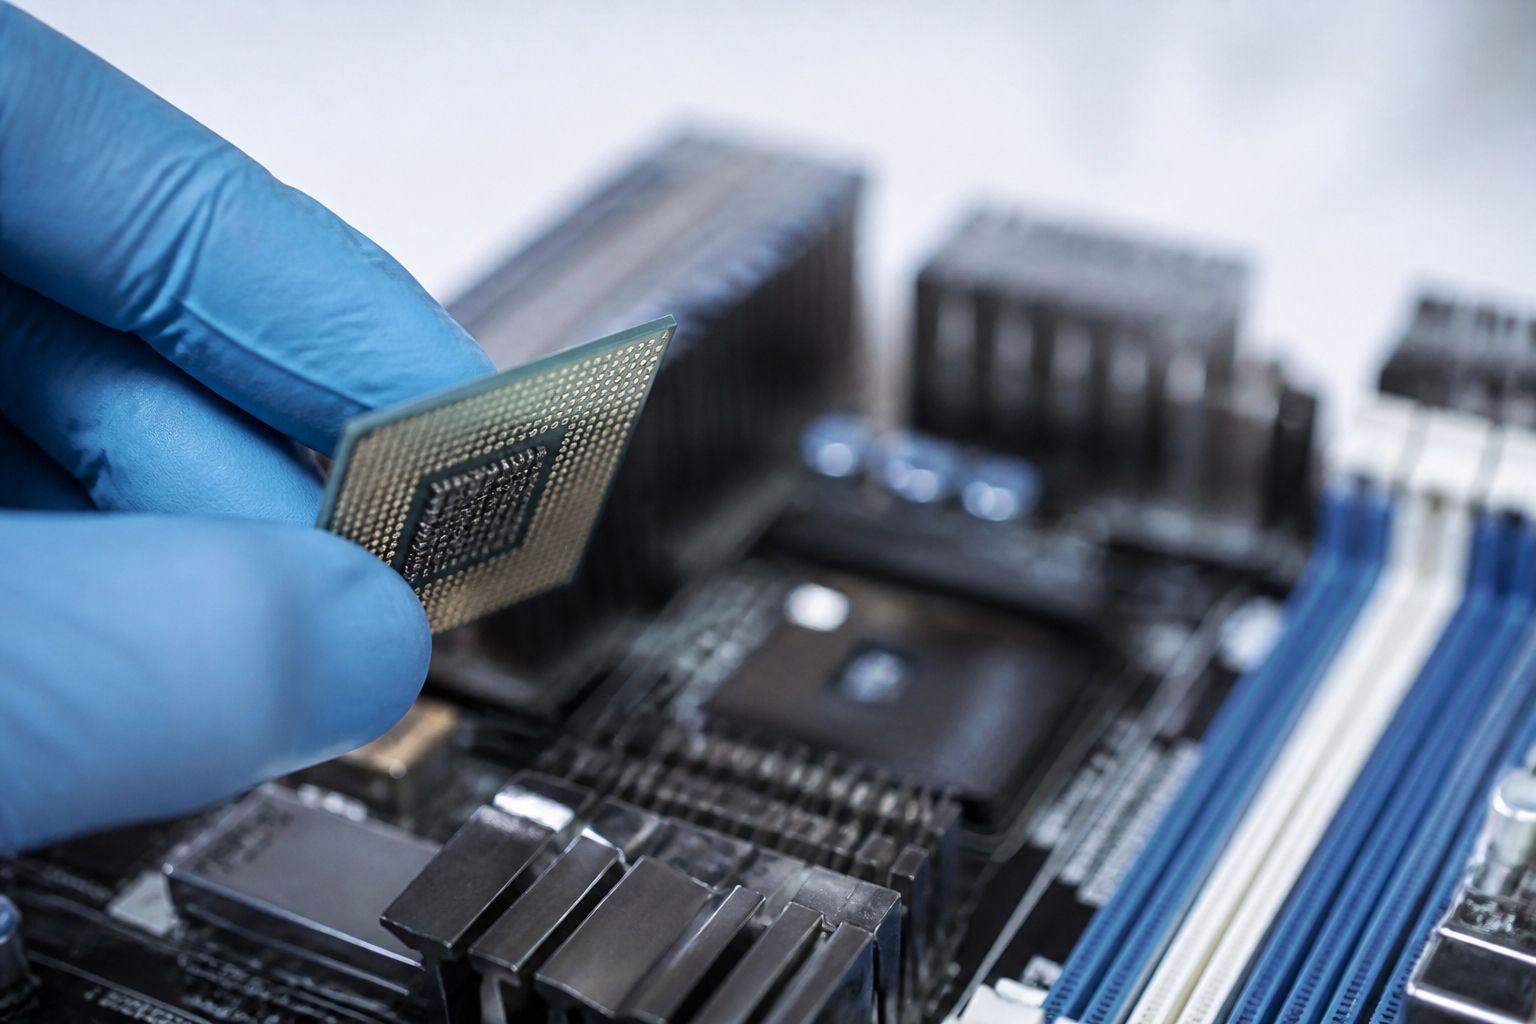
OpenAI ha presentado Jalapeño, su primer chip propio para inteligencia artificial, desarrollado junto a Broadcom y fabricado por TSMC. El procesador alcanza hasta 13,4 petaflops de rendimiento en operaciones de 4 bits, incorpora 232 GB de memoria HBM y ofrece un ancho de banda de 15,4 TB por segundo.
El dato más relevante no es solo su potencia. En tareas de inferencia, es decir, cuando un modelo ya entrenado genera respuestas, Jalapeño puede reducir hasta 3,6 veces la latencia frente al GB300 de Nvidia, el hardware que OpenAI utiliza actualmente para ejecutar sus modelos. Además, lo hace con un consumo energético inferior.
Un desarrollo acelerado con inteligencia artificial
OpenAI anunció oficialmente Jalapeño el 24 de junio de 2026, después de completar el diseño desde el concepto arquitectónico hasta el silicio en menos de 20 meses. La fase que va desde el código inicial hasta la fabricación se resolvió en apenas nueve meses.
El proyecto contó con un equipo medio de menos de 100 personas. La compañía atribuye buena parte de esta velocidad al uso de sus propios modelos de inteligencia artificial como herramientas para ayudar a los ingenieros en determinadas etapas del diseño.
La IA se utilizó sobre todo en el front-end, la fase en la que se define el comportamiento del chip y se escribe el código que describe sus circuitos. Para ello, el equipo recurrió a herramientas como XLS, un lenguaje de descripción de hardware de alto nivel, y Codex, el sistema de OpenAI orientado a generar y revisar código.
Este tipo de software permite expresar el funcionamiento de un procesador de una forma relativamente parecida a la programación convencional. Por ese motivo, los modelos de IA pueden ayudar a redactar especificaciones, proponer estructuras, detectar errores y acelerar tareas repetitivas que antes exigían muchas horas de trabajo especializado.
La IA no sustituye a los ingenieros de chips
El avance no significa que una empresa pueda crear un procesador avanzado introduciendo unas instrucciones en un chatbot. La inteligencia artificial multiplicó la productividad de un equipo altamente especializado, pero no eliminó la necesidad de conocimiento humano.
La parte más compleja continúa estando en el back-end. En esta etapa, el diseño lógico se convierte en una disposición física de transistores y conexiones. Los ingenieros deben resolver restricciones de espacio, consumo, temperatura y sincronización para garantizar que el chip funcione correctamente cuando se fabrique.
OpenAI asumió el diseño del sistema, mientras Broadcom se encargó de buena parte del trabajo físico y de implementación. Esta división permitió que cada compañía se concentrara en sus competencias y evitó que OpenAI tuviera que crear desde cero una organización dedicada al diseño físico de semiconductores.
Qué significan sus cifras técnicas
Los petaflops miden la capacidad de realizar billones de operaciones matemáticas por segundo. En este caso, el rendimiento se calcula con datos de 4 bits, un formato de baja precisión que resulta especialmente útil en inferencia porque reduce el espacio ocupado por los modelos y el consumo de memoria.
La memoria HBM, o memoria de alto ancho de banda, almacena los datos que necesita el procesador y los suministra a gran velocidad. Los 232 GB disponibles y la conexión de 15,4 TB por segundo permiten mover grandes volúmenes de información con menos esperas, un factor decisivo cuando un centro de datos debe atender millones de peticiones.
La latencia es el tiempo que transcurre desde que llega una solicitud hasta que comienza o termina la respuesta. Reducirla resulta especialmente importante en asistentes conversacionales, servicios de generación de código y aplicaciones empresariales que necesitan respuestas inmediatas.
Un primer paso para reducir la dependencia de Nvidia
Jalapeño representa un movimiento estratégico para OpenAI. La compañía depende actualmente de las GPU de Nvidia, que siguen siendo el estándar dominante para entrenar grandes modelos y ejecutar servicios de inteligencia artificial a escala.
Sin embargo, la inferencia se está convirtiendo en uno de los principales costes operativos del sector. Cada respuesta generada requiere capacidad de cómputo y memoria, y el gasto crece a medida que aumentan los usuarios y la complejidad de los modelos.
Disponer de un chip diseñado específicamente para las cargas de trabajo de OpenAI puede reducir el coste por consulta, mejorar el rendimiento y ofrecer un mayor control sobre la infraestructura. Los centros de datos que la empresa está construyendo en Canadá aparecen como uno de los destinos naturales para estas unidades.
La carrera por los chips propios se intensifica
OpenAI no es la única gran tecnológica que intenta limitar su dependencia de Nvidia. Google desarrolla sus TPU, Amazon utiliza las familias Trainium e Inferentia y Microsoft ha creado sus chips Maia y Cobalt para distintas tareas de inteligencia artificial y computación en la nube.
La diferencia es que Jalapeño llega tras un ciclo de desarrollo especialmente corto y con cifras de rendimiento que lo sitúan como un competidor relevante en inferencia. El uso de IA en el diseño del hardware puede convertirse así en una ventaja adicional para las compañías que ya cuentan con capital, especialistas y acceso a fabricantes avanzados.
El impacto sobre Nvidia no será inmediato. Sus GPU continuarán siendo necesarias durante años, especialmente para entrenar modelos de gran tamaño. Pero la situación cambia si los principales clientes empiezan a ejecutar una parte cada vez mayor de sus servicios con chips propios.
El siguiente reto para OpenAI será ampliar la producción y demostrar que Jalapeño mantiene sus resultados fuera de las pruebas iniciales. El chip no marca el final de la dependencia de Nvidia, pero sí confirma que la compañía ya ha construido una vía tecnológica creíble para reducirla.