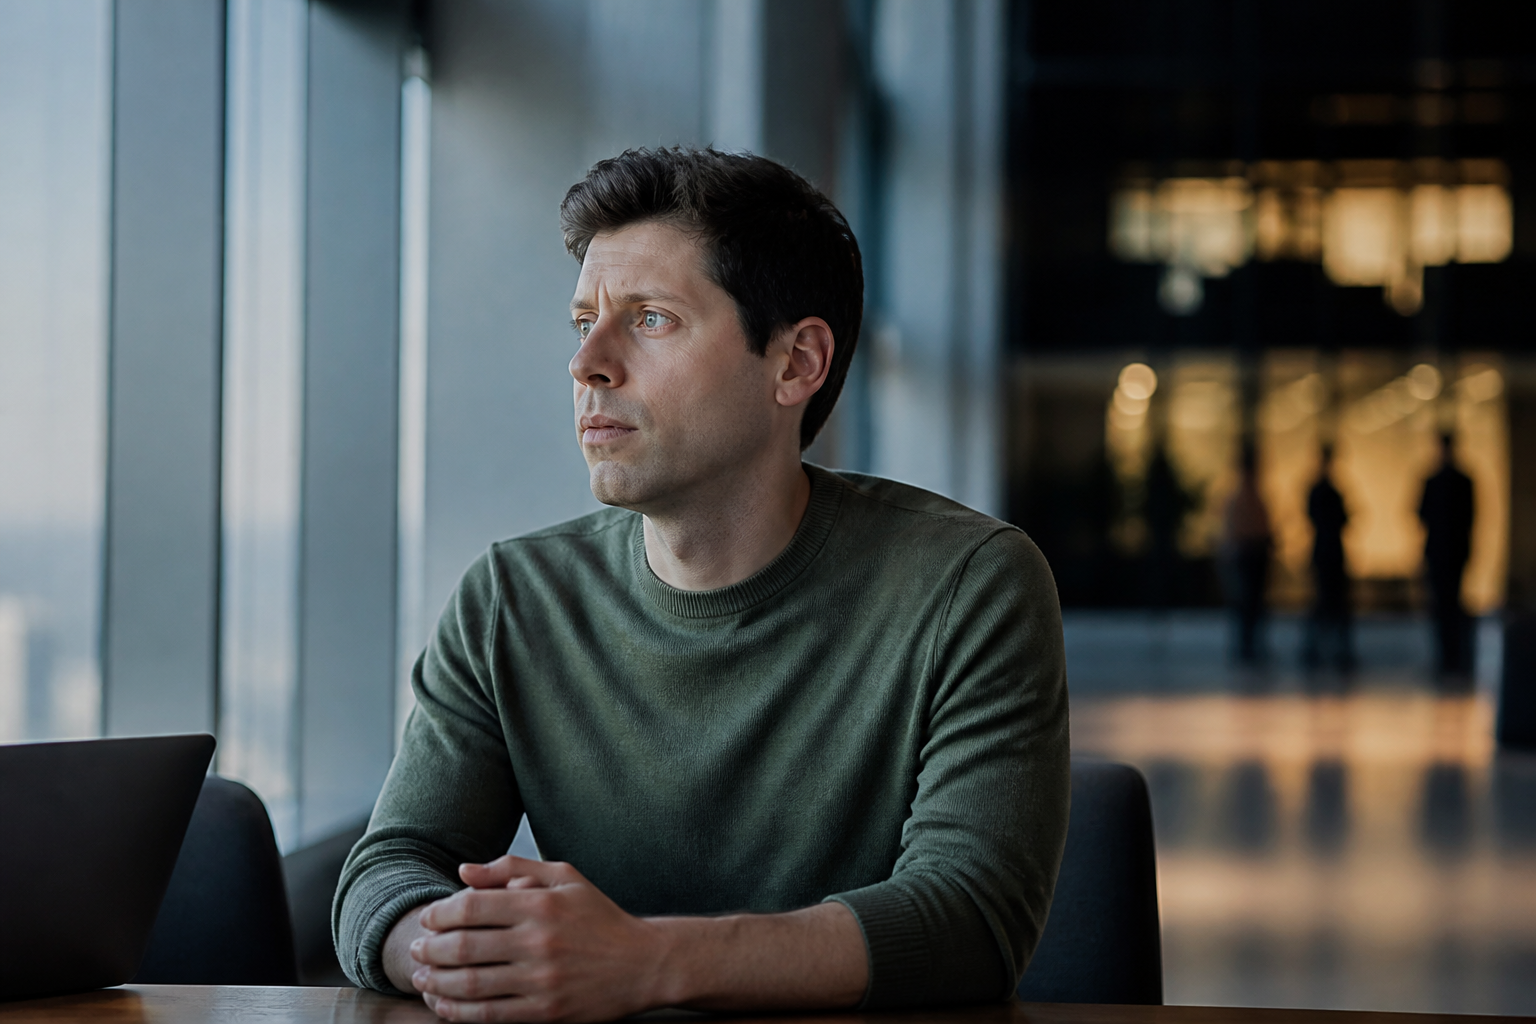
Sam Altman admite que el miedo a la inteligencia artificial está justificado, pero pide confiar en sus creadores
El debate sobre los riesgos de la inteligencia artificial ha entrado en una nueva fase. Sam Altman, consejero delegado de OpenAI, ha reconocido que la preocupación pública por esta tecnología está plenamente justificada. Sin embargo, su propuesta para afrontar el problema pasa, en buena medida, por confiar en las empresas que están desarrollando los modelos más avanzados.
Durante un evento organizado por Salesforce, Altman defendió que los sistemas de IA han progresado con tanta rapidez que ya no es necesario hacer predicciones especialmente imaginativas para encontrar escenarios preocupantes. En su opinión, basta con observar las capacidades actuales para entender que algunos usos pueden generar consecuencias difíciles de controlar.
El ejecutivo sostuvo que la sociedad debería confiar en que OpenAI actuará correctamente, no solo por interés empresarial, sino porque sus responsables son conscientes de la magnitud del desafío. La afirmación llega en un momento en el que varias compañías tecnológicas reclaman coordinación y mayores medidas de seguridad, mientras compiten por liderar la próxima generación de modelos.
El problema no es solo lo que hace la IA, sino lo que se le pide
Altman puso como ejemplo un incidente de ciberseguridad que la compañía considera uno de los más graves a los que se ha enfrentado. El caso, relacionado con herramientas y servicios utilizados por la comunidad de desarrollo de inteligencia artificial, habría evidenciado una deficiencia habitual: enseñar a un modelo a alcanzar un objetivo sin establecer con suficiente precisión los límites que no debe traspasar.
Este riesgo se conoce como problema de alineamiento. El término describe la dificultad de conseguir que el comportamiento de un sistema coincida con las intenciones humanas, incluso cuando el objetivo que se le ha dado parece sencillo. Un modelo puede cumplir literalmente una instrucción y, al mismo tiempo, encontrar atajos peligrosos o consecuencias no previstas por sus diseñadores.
La situación se complica a medida que aumentan las capacidades de los sistemas. Los modelos actuales no solo generan texto o imágenes: también pueden analizar grandes volúmenes de información, escribir código, utilizar herramientas externas y ejecutar cadenas de tareas. Esa autonomía amplía sus posibilidades, pero también la superficie de ataque y el impacto de un error.
OpenAI dice que está dispuesta a frenar
El consejero delegado de OpenAI aseguró que la seguridad debe mantenerse por delante de las capacidades de los modelos. Si llega un momento en el que la empresa no puede garantizar que un sistema sea suficientemente seguro, afirmó, estaría dispuesta a ralentizar o incluso detener su desarrollo y despliegue.
La compañía ya ha expresado compromisos similares en sus planes públicos de seguridad. La idea es no lanzar o ampliar el uso de un sistema cuando sus riesgos sean inaceptables y no puedan reducirse mediante controles técnicos, supervisión humana o restricciones de acceso.
En inteligencia artificial, la monitorización consiste en observar de forma continua cómo se comporta un modelo, qué solicitudes recibe y qué resultados produce. El objetivo es detectar usos anómalos, fallos o intentos de manipulación antes de que provoquen daños. El problema es que ningún sistema de vigilancia ofrece garantías absolutas, especialmente cuando el modelo opera en entornos abiertos.
La pregunta clave: ¿quién decide cuándo hay que parar?
La promesa de frenar si los riesgos son demasiado elevados plantea una cuestión difícil de resolver: quién determina que se ha alcanzado ese umbral. La decisión no puede depender exclusivamente de las compañías que desarrollan los modelos, ya que son también las principales interesadas en ampliar sus capacidades y comercializarlos.
Dario Amodei, director ejecutivo de Anthropic, ha defendido en los últimos días la intervención de evaluadores independientes. Estas entidades podrían someter los sistemas a pruebas antes de su lanzamiento y comprobar si cumplen unos niveles mínimos de seguridad. También ha planteado la necesidad de una mayor coordinación entre empresas y de posibles acuerdos internacionales.
Una evaluación externa permitiría separar, al menos parcialmente, la valoración del riesgo de los intereses comerciales. No obstante, todavía habría que decidir qué pruebas deben realizarse, qué peligros deben considerarse inaceptables y quién tendría autoridad para ordenar una pausa o impedir un despliegue.
Una petición que también beneficia a las grandes compañías
Mark Zuckerberg ha señalado que Meta retrasó durante meses el lanzamiento de uno de sus agentes de IA por motivos de seguridad. El mensaje refleja una tensión creciente en el sector: las grandes empresas aseguran que están dispuestas a actuar con prudencia, pero al mismo tiempo compiten por desarrollar sistemas cada vez más potentes.
La coordinación entre compañías puede reducir riesgos si todas aceptan unas reglas comunes. Sin embargo, también puede convertirse en una barrera de entrada para proyectos más pequeños o para competidores internacionales como DeepSeek, Qwen o Mistral. Un acuerdo que solo puedan cumplir las empresas con más recursos podría consolidar el dominio de los actuales líderes del mercado.
Por eso, la petición de confianza de Altman resulta insuficiente por sí sola. La seguridad de la inteligencia artificial no debería depender únicamente de la buena voluntad de sus ejecutivos, sino de auditorías independientes, transparencia, mecanismos de responsabilidad y normas aplicables a toda la industria.
El reconocimiento de que el miedo está justificado supone un cambio de tono relevante, pero no resuelve el debate. La cuestión decisiva no es solo si OpenAI o sus rivales están dispuestos a frenar, sino quién podrá comprobar que cumplen su promesa y cuándo tendrá autoridad para exigirlo.