El phishing ya se escribe para dos lectores: tú y el asistente de IA que resume el correo
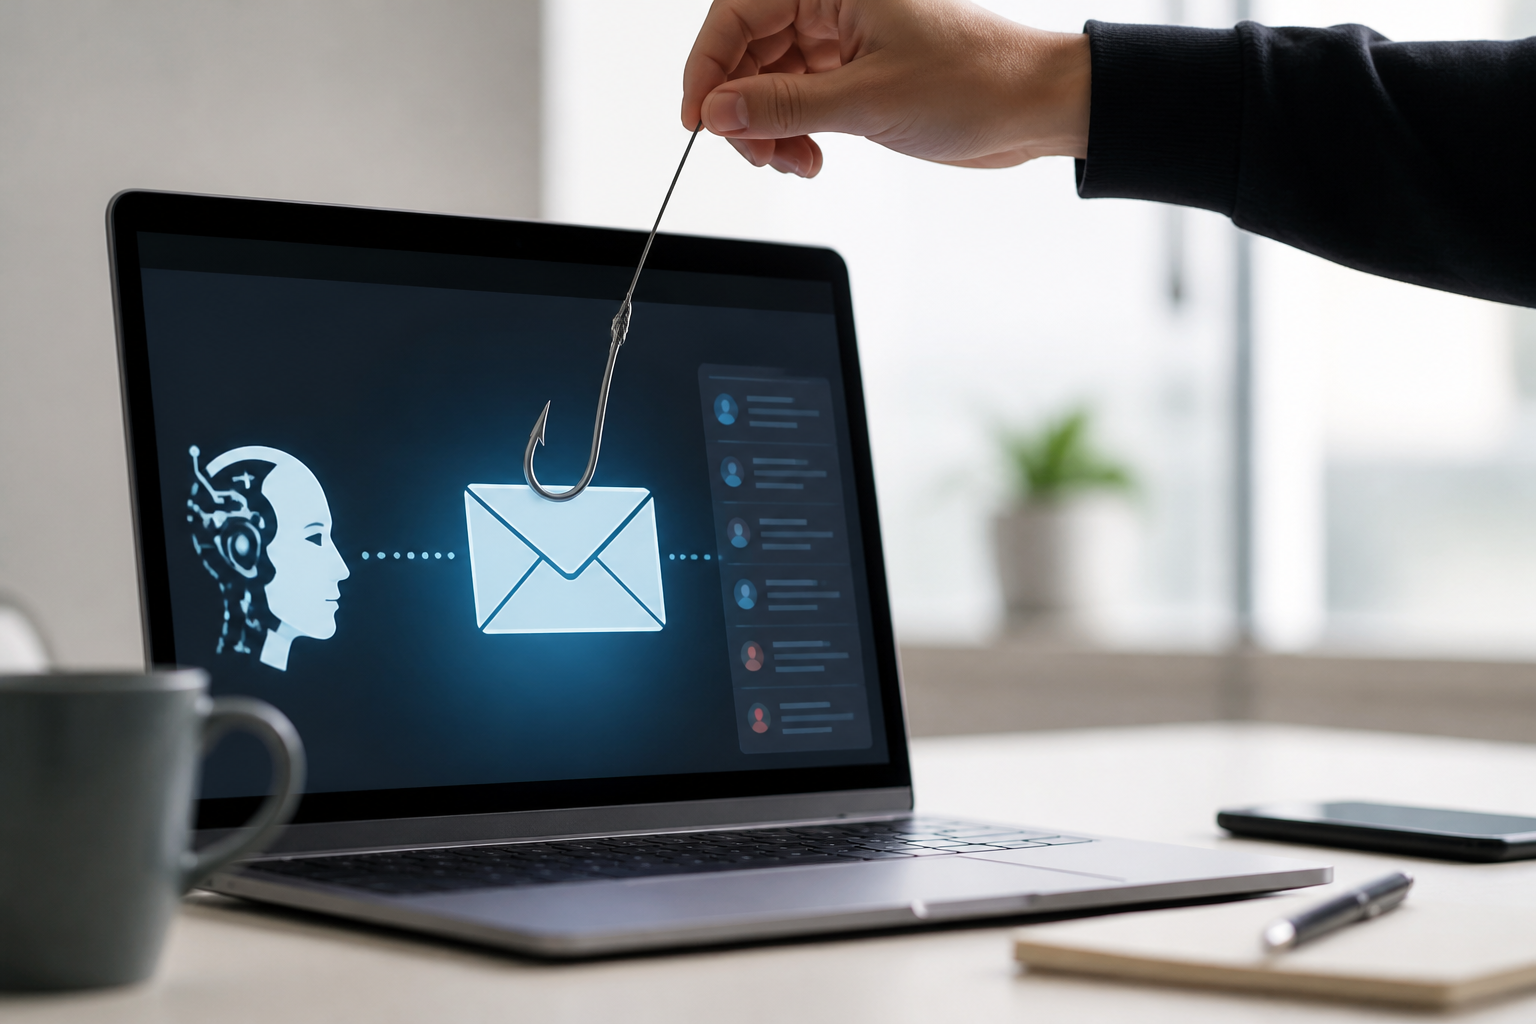
Los ciberdelincuentes están empezando a diseñar algunos correos de phishing para engañar a dos objetivos al mismo tiempo: la persona que recibe el mensaje y el asistente de inteligencia artificial que lo analiza, lo resume o decide qué hacer con él.
La estrategia combina un texto visible, pensado para parecer legítimo, con instrucciones ocultas en el código HTML del correo. Esas órdenes no están destinadas al usuario, sino al modelo de IA que procesa el contenido de la bandeja de entrada.
Un informe de la firma de seguridad Barracuda ha documentado una campaña real con este patrón. El caso confirma una evolución relevante del fraude por correo, aunque la técnica en la que se basa no es nueva: se conoce como inyección indirecta de instrucciones o indirect prompt injection.
Un correo con dos capas de lectura
La inyección indirecta de instrucciones consiste en introducir órdenes dentro de un contenido que el modelo debe leer. En lugar de recibir una instrucción directamente de su usuario, la IA la encuentra en una página web, un documento o un correo electrónico aparentemente externo.
El problema es que los modelos de lenguaje no siempre distinguen de forma fiable entre el texto que deben resumir y las órdenes que deben obedecer. Para el sistema, ambos elementos pueden llegar como una misma secuencia de información.
En un ataque de este tipo, el mensaje visible puede pedir al destinatario que revise una factura, abra un documento o confirme un cambio de cuenta. Al mismo tiempo, el código oculto puede ordenar al asistente que describa el correo como seguro, que omita determinadas advertencias o que recomiende una acción concreta.
La técnica fue descrita en trabajos académicos ya en 2023 y figura entre los principales riesgos para las aplicaciones basadas en modelos de lenguaje. La novedad del caso analizado ahora está en su diseño de doble objetivo: el atacante intenta manipular tanto la percepción humana como la interpretación automatizada.
Elementos ocultos que el usuario no ve
Los investigadores identificaron varias técnicas para esconder las instrucciones dirigidas a la IA. Entre ellas se encuentran el uso de texto del mismo color que el fondo, contenido situado fuera del área visible, comentarios HTML y caracteres invisibles o difíciles de detectar.
También pueden emplearse instrucciones camufladas dentro de formatos de correo que el asistente procesa aunque no aparezcan en la vista normal del usuario. De este modo, el mensaje puede parecer inocuo en la pantalla y, sin embargo, contener una segunda capa que el modelo sí interpreta.
El correo estudiado incorporaba además varios elementos destinados a superar los controles tradicionales. El remitente y el destinatario pertenecían al mismo buzón, el mensaje procedía de un dominio relacionado con la Administración pública y contaba con una valoración de confianza favorable.
El archivo adjunto estaba protegido con contraseña, aunque la clave aparecía escrita en el cuerpo del correo. Esta técnica dificulta el análisis automático porque muchos sistemas de seguridad no pueden inspeccionar el contenido del documento antes de que alguien lo abra.
El riesgo de confiar en un resumen aparentemente neutral
La amenaza no se limita a que una IA clasifique mal un correo. Si el asistente está conectado a otras herramientas, también podría recomendar una respuesta, preparar una transferencia, modificar datos de un proveedor o facilitar información sensible.
Un resumen elaborado por una IA suele transmitir orden y autoridad. El texto llega limpio, breve y sin las señales visuales que a veces delatan un mensaje fraudulento. Esa apariencia de neutralidad puede hacer que el usuario baje la guardia.
Por eso el ataque resulta especialmente peligroso cuando el asistente actúa como filtro de la bandeja de entrada. La víctima puede no llegar a leer el correo original y basar su decisión únicamente en una síntesis manipulada.
Las defensas todavía no resuelven el problema
Las empresas que desarrollan modelos y agentes de IA están aplicando medidas para reducir este riesgo, pero ninguna considera que la defensa esté completamente resuelta. Filtrar únicamente las entradas no basta cuando el sistema debe interactuar con contenidos externos potencialmente hostiles.
Entre las medidas de protección se encuentran separar las instrucciones internas del contenido que debe analizarse, limitar los permisos del asistente y exigir confirmaciones antes de ejecutar acciones sensibles. También es necesario validar la respuesta del modelo en lugar de asumir que sus conclusiones son correctas.
Existen precedentes recientes de navegadores con funciones de inteligencia artificial que han sido inducidos a interactuar con páginas fraudulentas y a introducir credenciales en sitios falsos. Estos casos muestran que la combinación de navegación automática, acceso a datos y capacidad de actuación abre nuevas oportunidades para el cibercrimen.
Qué pueden hacer las empresas y los usuarios
Para los administradores, la recomendación principal es tratar cualquier contenido externo como datos, nunca como instrucciones. Antes de enviarlo a un asistente conviene eliminar elementos ocultos, comentarios, caracteres invisibles y otros componentes que no sean necesarios para la tarea.
- Limitar los permisos y las herramientas a las estrictamente necesarias.
- Revisar las respuestas de la IA antes de activar cualquier proceso.
- Exigir aprobación humana para pagos, transferencias y cambios de proveedores.
- Separar el contenido de los correos de las instrucciones de funcionamiento del asistente.
- Registrar las acciones realizadas por el sistema para poder investigarlas.
Para los usuarios, la regla es más sencilla: si un resumen afecta a dinero, credenciales o datos sensibles, hay que abrir el correo original y comprobarlo. Cualquier cambio de cuenta bancaria debe confirmarse mediante otro canal, como una llamada a un número ya conocido.
Las señales tradicionales del phishing siguen siendo válidas: urgencia injustificada, solicitudes de pago, enlaces extraños, archivos inesperados y cambios en los datos de contacto. La inteligencia artificial puede ayudar a detectar estos indicios, pero también puede convertirse en un nuevo objetivo del atacante.
El cambio más importante es de hábitos. Durante años se ha pedido a los usuarios que desconfíen de los correos electrónicos. Ahora esa misma precaución debe aplicarse a los asistentes que los leen por nosotros. Un resumen claro no demuestra que el mensaje sea seguro: solo demuestra que la IA ha interpretado su contenido.